Au chapitre 1, on a installé Qwen3 8B dans Ollama sur jarvis (le Mac mini M4), Open WebUI et SearXNG en Docker Compose sur viviane. Au chapitre 2, n8n est venu lire LogStream toutes les minutes, compter les tentatives SSH, et ne réveiller Qwen que pour rédiger deux phrases dans Telegram. J’avais promis la suite : du RAG sur ma propre documentation, des outils MCP, et un modèle un peu plus autonome. Le montage s’est révélé plus riche que prévu (et plus piégeux ^^), alors j’ai coupé en deux : ce chapitre est consacré au RAG, le chapitre 4 sera lui consacré à MCP et au réglage fin du modèle.
Le fil rouge : Qwen ne sait rien de vBlog.io. Le RAG va lui donner accès aux 669 articles du blog, sans réentraîner quoi que ce soit, et n8n va se charger de garder cette base à jour toute seule. La règle du chapitre 2 tient toujours : le modèle explique, il ne décide pas, et il ne déclenche jamais d’action. Tout ce qu’on branche ici est en lecture seule.
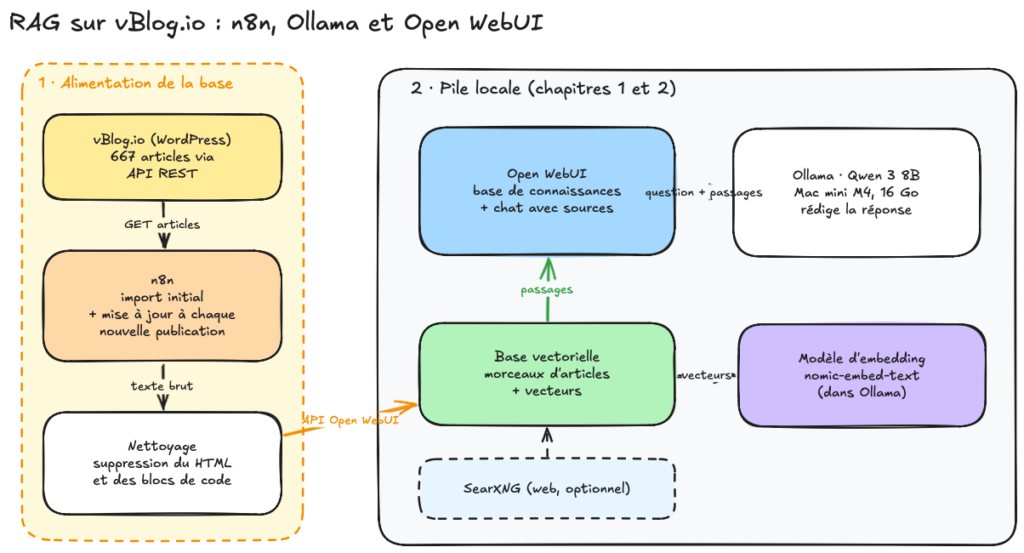
On ne casse rien de ce qui existe : on ajoute un modèle d’embedding sur jarvis, un conteneur Qdrant à côté d’Open WebUI, et deux workflows n8n.
Le Lab
- Le modèle d’embedding : servi par Ollama sur jarvis, il transforme les textes en vecteurs.
- Qdrant : la base vectorielle, dans le compose d’Open WebUI sur viviane.
- L’ingestion : n8n lit les articles publiés via l’API REST de WordPress, les nettoie et les pousse dans une base de connaissances Open WebUI. Open WebUI les découpe, demande les vecteurs à Ollama et les range dans Qdrant.
| Composant | Où | Rôle dans ce chapitre |
|---|---|---|
| Ollama + jarvis-qwen3 | jarvis (natif) | Modèle de chat |
| Ollama + qwen3-embedding:0.6b | jarvis (natif) | Calcul des vecteurs |
| Open WebUI v0.12.5 | viviane (Compose) | Base de connaissances |
| Qdrant v1.20.0 | viviane (Compose) | Base vectorielle |
| n8n | viviane (Compose) | Workflow d’ingestion des articles WordPress vers la base vectorielle |
| WordPress (vBlog.io) | Sur Dédié OVH | Source des articles, lecture seule |
Open WebUI est le seul point d’entrée côté utilisateur : il demande les vecteurs à Ollama et cherche dans Qdrant. n8n, lui, ne fait qu’alimenter la base.
Le RAG, sans le jargon
RAG, pour Retrieval-Augmented Generation. Derrière l’acronyme, c’est exactement ce qu’on a fait avec SearXNG au chapitre 1 : on va chercher des morceaux de texte pertinents, on les colle dans le prompt, et le modèle répond en s’appuyant dessus. La seule différence, c’est que la recherche se fait dans une base qu’on a construite, et pas sur le web.
Les poids de Qwen ne bougent pas d’un octet. Pas de fine-tuning, pas de GPU qui fume pendant trois jours. Si j’écris un nouvel article demain, il suffit de l’ajouter à la base.
Les étapes, côté ingestion
- Découpage (chunking) : chaque article est coupé en morceaux d’environ 1 000 caractères, avec 100 caractères de recouvrement pour ne pas couper une idée en deux. Ce sont les valeurs par défaut d’Open WebUI (
CHUNK_SIZEetCHUNK_OVERLAP). - Embedding : chaque morceau passe dans un modèle spécialisé, qui le transforme en un vecteur de quelques centaines à quelques milliers de nombres. Deux textes qui parlent de la même chose donnent des vecteurs proches, même s’ils n’utilisent pas les mêmes mots.
- Stockage : les vecteurs et le texte d’origine sont rangés dans une base vectorielle, ici Qdrant.
Les étapes, côté question
- La question passe dans le même modèle d’embedding. Ce point est non négociable : un vecteur calculé par un modèle n’a aucun sens pour un autre.
- La base renvoie les morceaux les plus proches, par similarité cosinus. Open WebUI en garde 3 par défaut (
RAG_TOP_K). - Ces morceaux sont injectés dans le prompt, avec une consigne du genre « réponds à partir de ce contexte, et cite tes sources ». Le modèle de chat rédige la réponse.
Pour les architectes : c’est un index secondaire. Le modèle d’embedding est la fonction d’indexation, Qdrant est l’index, et le contexte du LLM est le cache dans lequel on charge les quelques blocs utiles. Si l’index renvoie les mauvais blocs, le meilleur modèle du monde répondra à côté. Dans un RAG, la qualité se joue d’abord sur la recherche, pas sur la génération.
Le modèle d’embedding, sur jarvis
Open WebUI sait calculer les embeddings tout seul, dans son conteneur, avec sentence-transformers/all-MiniLM-L6-v2 par défaut. Deux problèmes : il tourne alors sur le CPU de viviane, et c’est un modèle entraîné essentiellement sur de l’anglais. Mon blog est en français, truffé de termes techniques en anglais. Autant confier le travail à Ollama, sur le GPU du Mac mini.
Quel modèle ?
| Modèle Ollama | Taille | Contexte | Multilingue | Verdict |
|---|---|---|---|---|
| nomic-embed-text | 274 Mo | 2K | Orienté anglais (donc pas pour nous) | Écarté |
| bge-m3 | 1,2 Go | 8K | Plus de 100 langues | Bon plan B |
| qwen3-embedding:0.6b | 639 Mo | 32K | Plus de 100 langues | Retenu |
J’ai retenu qwen3-embedding:0.6b : même famille que notre modèle de chat, multilingue, et léger. Les variantes 4b (2,5 Go) et 8b (4,7 Go) existent, mais avec 16 Go de mémoire unifiée et Qwen3 8B déjà chargé (5,6 Go selon ollama ps), ça me laisse un peu de marge.
Installation et premier test
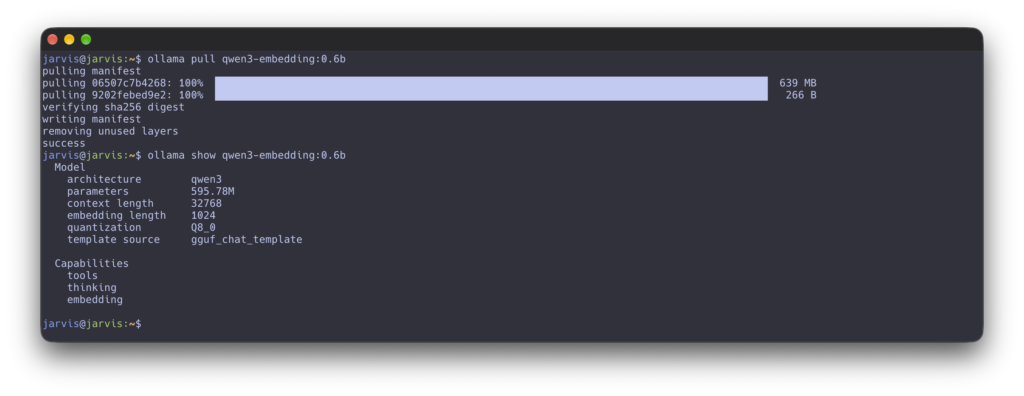
Pas de ollama run ici : un modèle d’embedding ne discute pas, il renvoie des matrices de nombres (des vecteurs). On le teste directement par l’API, depuis viviane pour vérifier le chemin réseau au passage :
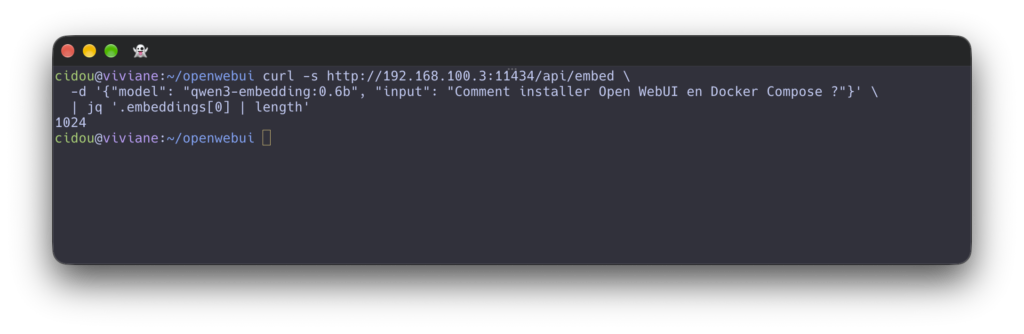
La réponse doit être la dimension du vecteur, 1024 pour la version 0.6b. Le champ input accepte aussi un tableau de chaînes, pour vectoriser par lots (doc Ollama).
Les deux modèles en même temps
Pendant une conversation RAG, Ollama doit garder les deux modèles en mémoire : l’embedding pour vectoriser la question, Qwen3 pour répondre. Par défaut, Ollama en garde jusqu’à 3 chargés simultanément (FAQ, OLLAMA_MAX_LOADED_MODELS), donc rien à régler. En revanche, la première ingestion va envoyer des milliers de morceaux à vectoriser : laissez jarvis tranquille pendant ce temps-là.
Qdrant et Open WebUI, sur viviane
Par défaut, Open WebUI range ses vecteurs dans une base Chroma embarquée, sous /app/backend/data/vector_db, dans le même volume que tout le reste. Ça marche, mais je préfère séparer pour bien tout comprendre : un conteneur, une fonction, un volume. Qdrant fait partie des bases supportées par Open WebUI via la variable VECTOR_DB (avec Chroma, pgvector, Milvus, OpenSearch, Elasticsearch et quelques autres, code source). Il a un tableau de bord web pour voir ce qu’il y a dedans, et il se sauvegarde par snapshots.
Le docker-compose.yml complet
Voici ~/openwebui/docker-compose.yml dans son état après ce chapitre. Les ajouts sont commentés.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 |
services: open-webui: image: ghcr.io/open-webui/open-webui:${OWUI_VERSION:-v0.12.5} container_name: open-webui restart: unless-stopped ports: - "${WEBUI_PORT:-3000}:8080" environment: - OLLAMA_BASE_URL=${OLLAMA_BASE_URL:-http://192.168.100.3:11434} - WEBUI_SECRET_KEY=${WEBUI_SECRET_KEY} - WEBUI_NAME=${WEBUI_NAME:-Jarvis} - TZ=Europe/Paris # Chapitre 3 : base vectorielle externe (lues à chaque démarrage) - VECTOR_DB=qdrant - QDRANT_URI=http://qdrant:6333 - QDRANT_API_KEY=${QDRANT_API_KEY:?QDRANT_API_KEY manquante dans .env} # Chapitre 3 : embeddings par Ollama (lues au premier démarrage seulement, voir plus bas) - RAG_EMBEDDING_ENGINE=ollama - RAG_EMBEDDING_MODEL=qwen3-embedding:0.6b - RAG_OLLAMA_BASE_URL=${OLLAMA_BASE_URL:-http://192.168.100.3:11434} volumes: - open-webui-data:/app/backend/data # Chapitre 3 : la limite par défaut (1024 fichiers ouverts) ne tient pas l'import initial ulimits: nofile: soft: 65536 hard: 65536 networks: - default # pour joindre searxng et qdrant - traefik-net # pour joindre n8n, et être joint par lui depends_on: - searxng - qdrant searxng: image: docker.io/searxng/searxng:${SEARXNG_VERSION:-2026.10.30-ffa88e3ba} container_name: searxng restart: unless-stopped environment: - SEARXNG_SECRET=${SEARXNG_SECRET:?SEARXNG_SECRET manquante dans .env} - TZ=Europe/Paris volumes: - ./searxng:/etc/searxng - searxng-cache:/var/cache/searxng # Chapitre 3 : base vectorielle qdrant: image: docker.io/qdrant/qdrant:${QDRANT_VERSION:-v1.20.0} container_name: qdrant restart: unless-stopped environment: - QDRANT__SERVICE__API_KEY=${QDRANT_API_KEY:?QDRANT_API_KEY manquante dans .env} - TZ=Europe/Paris # Tableau de bord uniquement en local, via un tunnel SSH # ports: # si vous voulez accéder au dashboard # - "6333:6333" volumes: - qdrant-data:/qdrant/storage volumes: open-webui-data: searxng-cache: qdrant-data: networks: traefik-net: external: true |
Le bloc ulimits n’était pas là au départ. Il est arrivé après un premier import complet qui s’est arrêté net au 333e article, avec OSError: [Errno 24] Too many open files dans les logs d’Open WebUI : les versions récentes de Docker donnent aux conteneurs une limite soft de 1024 descripteurs, et chaque fichier traité ouvre des connexions vers Ollama et Qdrant. Le réseau traefik-net, lui, est expliqué plus bas.
Et les ajouts au .env, dans le même esprit qu’au chapitre 1 :
|
1 2 3 4 5 6 7 8 9 10 |
OWUI_VERSION=v0.12.5 WEBUI_PORT=3000 OLLAMA_BASE_URL=http://192.168.100.3:11434 WEBUI_NAME=Jarvis WEBUI_SECRET_KEY=xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx SEARXNG_SECRET=xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx QDRANT_VERSION=v1.20.0 QDRANT_API_KEY=xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx RAG_EMBEDDING_ENGINE=ollama RAG_EMBEDDING_MODEL=qwen3-embedding:0.6b |
Pas de port publié sur l’interface réseau de viviane pour Qdrant : Open WebUI le joint par son nom de service, sur le réseau du projet (ici traefik-net). Le tableau de bord est accessible au besoin (il demande la clé d’API).
Le piège de la PersistentConfig
C’est celui qui va vous coûter une heure si personne ne vous prévient. Open WebUI distingue deux familles de variables :
- Celles lues à chaque démarrage, comme
VECTOR_DBetQDRANT_URI. - Celles dites « persistantes », comme
RAG_EMBEDDING_ENGINE,RAG_EMBEDDING_MODEL,RAG_OLLAMA_BASE_URL,CHUNK_SIZEouRAG_TOP_K. Elles ne servent qu’au premier démarrage, puis leur valeur est stockée en base, et c’est la base qui gagne ensuite (config.py,ENABLE_PERSISTENT_CONFIGvautTruepar défaut).
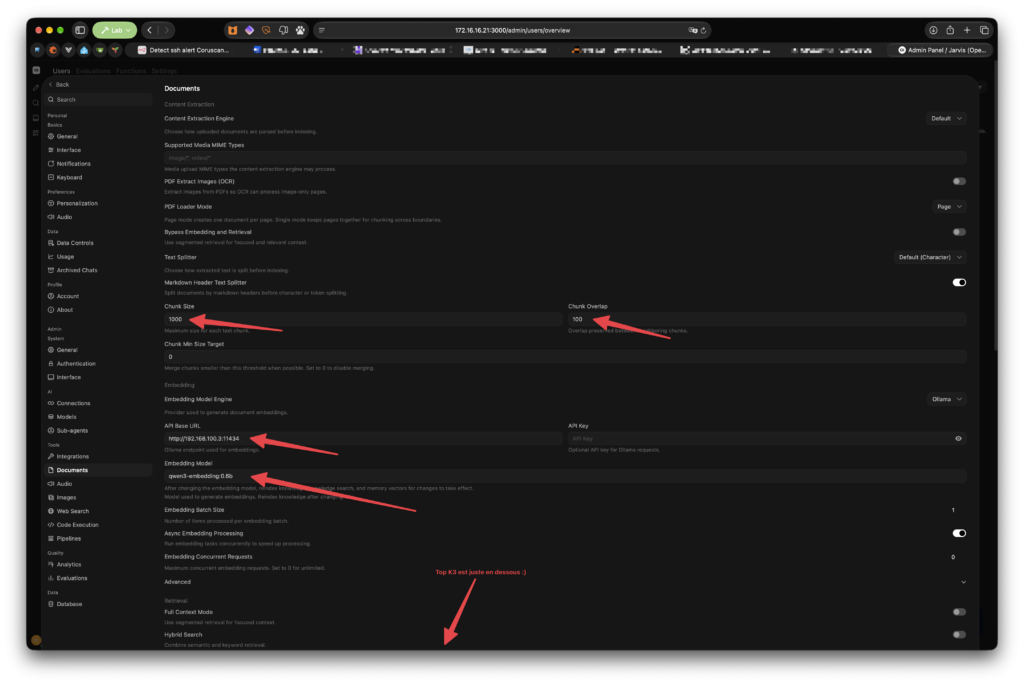
Notre Open WebUI tourne depuis le chapitre 1 : les variables RAG_* ajoutées ci-dessus seront donc ignorées. Je les laisse dans le fichier, parce qu’elles documentent la configuration et qu’elles serviront si je repars d’un volume vide. Mais le réglage effectif se fait dans Admin Panel > Settings > Documents :
- Moteur du modèle d’embedding : Ollama, URL
http://192.168.100.3:11434 - Modèle d’embedding :
qwen3-embedding:0.6b - Taille des morceaux 1000, recouvrement 100, Top K 3 : on garde les valeurs par défaut pour commencer.
Autre conséquence : changer de modèle d’embedding après coup oblige à tout revectoriser, puisque les anciens vecteurs ne veulent plus rien dire pour le nouveau modèle. Choisissez avant d’importer 669 articles, pas après.
La base de connaissances, le compte n8n et la clé d’API
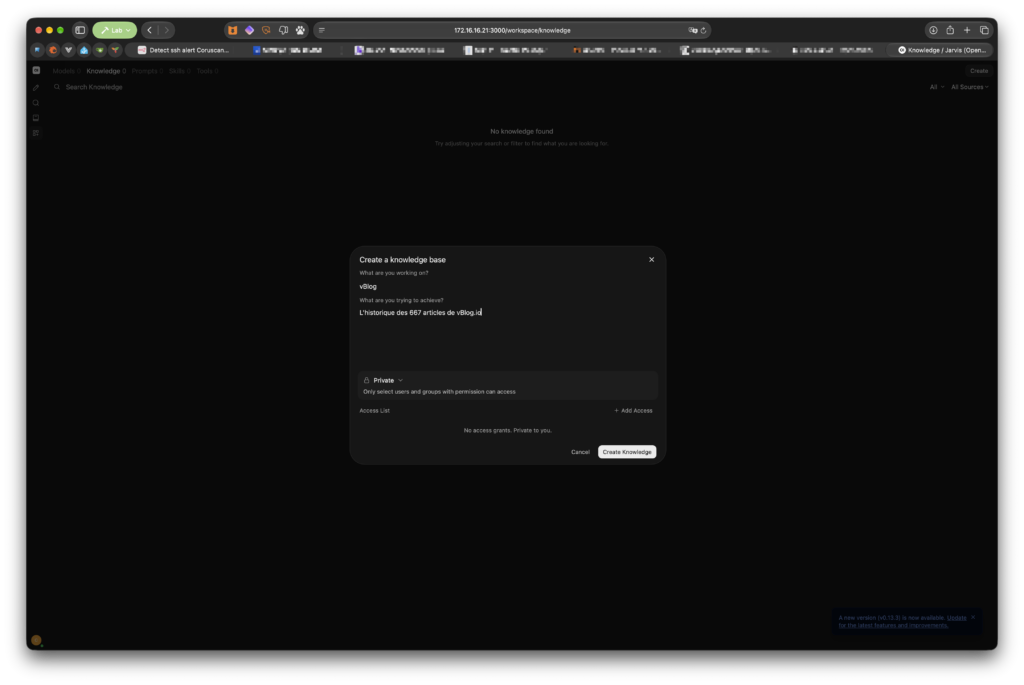
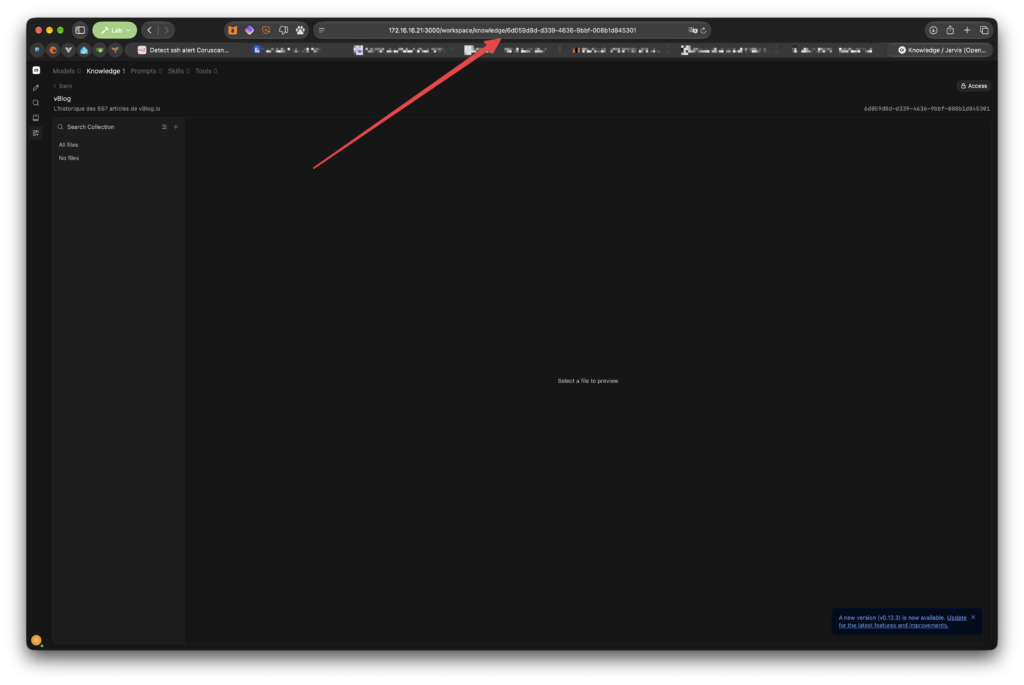
Dans Workspace > Knowledge, on crée une base nommée vBlog. Son identifiant est la dernière partie de l’URL de la page : on le note, n8n en aura besoin.
Pour que n8n puisse écrire dedans, il lui faut une clé d’API Open WebUI. Je ne voulais pas lui donner la mienne (administrateur), donc compte dédié. Et là, j’ai mis un moment à trouver, parce que c’est verrouillé à trois endroits :
- Admin Panel > Settings > Authentication : activer API Keys. C’est une variable persistante (
ENABLE_API_KEYS), inutile de la mettre dans le compose sur une instance existante. - Admin Panel > Users : créer l’utilisateur
n8n, rôle user. Puis dans Groups, créer un groupe (chez moigroup-api), y cochern8n(mon premier groupe avait zéro membre, et je me demandais pourquoi rien ne marchait ^^), et lui donner la permission Features > API Keys. - Workspace > Knowledge > vBlog > Access : partager la base avec ce groupe, en Write. Sans ça, l’envoi des fichiers fonctionne, mais l’ajout à la base répond « You do not have permission to access this resource ».
Ensuite seulement, connecté en n8n, le bloc API Keys apparaît dans Settings > Account. La clé (sk-…) s’utilise en Authorization: Bearer (doc API). Un test rapide depuis viviane :
|
1 2 |
curl -s -H "Authorization: Bearer sk-..." \ http://localhost:3000/api/v1/knowledge/<KID>/files | jq |
Avec une base vide, on obtient "items": [] et "total": 0.
Alimenter la base depuis WordPress, avec n8n
On pourrait glisser-déposer 669 fichiers dans Open WebUI. Une fois. Mais le jour où je corrige une coquille dans un vieil article (et il y en a ^^), la base est déjà fausse. Il faut donc que la base suive le blog toute seule, et c’est un travail pour n8n.
Une boucle de réconciliation
Plutôt que de mémoriser ce qui a déjà été importé (le curseur du chapitre 2, dans les static data), j’ai choisi une approche sans état, à la Kubernetes : on compare l’état voulu (les articles publiés) à l’état réel (les fichiers de la base de connaissances), et on corrige l’écart.
L’astuce tient dans le nom du fichier : wp-<id>-<slug>-<date de dernière modification>.md, par exemple wp-13295-decouverte-de-lia-locale-chapitre-2-n8n-et-analyse-de-logs-avec-logstream-20261106T170416.md. Le slug n’est pas indispensable à la réconciliation, mais c’est lui qui s’affiche dans les citations d’Open WebUI, et il donne directement l’URL de l’article. Ensuite, c’est une simple différence d’ensembles :
- Un article dont le nom de fichier n’existe pas dans la base : on l’ajoute. C’est le cas d’un nouvel article, mais aussi d’un article modifié, puisque sa date a changé.
- Un fichier
wp-*dont le nom ne correspond plus à aucun article : on le retire. C’est l’ancienne version d’un article modifié, ou un article dépublié.
Bonus : le workflow peut tourner autant de fois qu’on veut, en manuel comme en planifié, sans risque de doublon. Et contrairement aux static data, qui ne sont enregistrées que lors des exécutions de production, il fonctionne aussi pendant les tests.
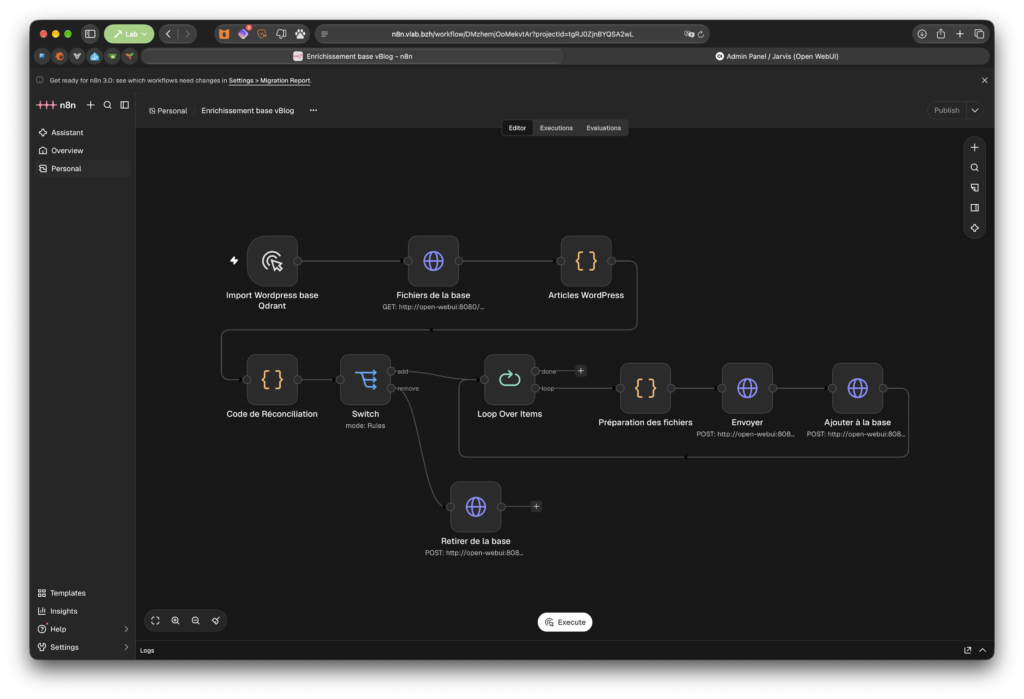
Le workflow « Enrichissement base vBlog », nœud par nœud
- Manual Trigger pour l’import initial et les tests branché sur le nœud suivant.
- HTTP Request « Fichiers de la base » : liste les fichiers déjà présents.
- Code « Articles WordPress » : récupère tous les articles publiés.
- Code « Réconciliation » : calcule ce qu’il faut ajouter et retirer.
- Switch sur le champ
action: une sortieremove, une sortieadd. - Sortie
remove: HTTP Request « Retirer de la base ». - Sortie
add: Loop Over Items par paquets de 5, qui enchaîne pour chaque paquet Code « Préparation des fichiers », HTTP Request « Envoyer » et HTTP Request « Ajouter à la base », dont la sortie revient sur l’entrée de la boucle.
Pour les appels à Open WebUI, une seule credential n8n de type Bearer Auth, avec la clé du compte n8n. L’identifiant de la base de connaissances est noté <KID> ci-dessous.
Fichiers de la base
GET sur http://open-webui:8080/api/v1/knowledge/<KID>/files. La réponse est paginée : 30 fichiers par page, dans un tableau items (le paramètre limit existe, mais il est réservé aux administrateurs). Dans les options du nœud, on active Pagination :
- Mode : Update a Parameter in Each Request, type Query, nom
page, valeur{{ $pageCount + 1 }} - Pagination Complete When : Other, expression
{{ $response.body.items.length === 0 }}
Ne faites pas l’impasse dessus « parce que la base est vide » : c’est exactement ce que j’ai fait. Au premier import, aucun souci. À la relance, le nœud ne voyait que les 30 premiers fichiers, la réconciliation en déduisait que 639 articles manquaient, et Open WebUI refusait de les ajouter une deuxième fois (« Duplicate content detected »). Avec la pagination, on obtient 24 items pour 669 fichiers : 23 pages pleines, plus la page vide qui arrête la boucle.
Ces routes ont été vérifiées dans le code source d’Open WebUI. L’API bouge vite entre deux versions : contrôlez la réponse sur la vôtre avant de câbler la suite.
Articles WordPress
L’API REST de WordPress renvoie 100 articles au maximum par page, et le nombre de pages dans l’en-tête X-WP-TotalPages (doc pagination). L’appel est anonyme : sans authentification, WordPress ne renvoie que les articles publiés, les brouillons ne peuvent donc pas fuir dans la base. _fields limite la réponse aux champs utiles (paramètres globaux).
Comme au chapitre 2, je ne suis toujours pas développeur JavaScript : Jarvis m’a écrit ce nœud, en mode Run Once for All Items.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 |
const base = 'https://vblog.io/wp-json/wp/v2/posts'; const posts = []; let page = 1, totalPages = 1; do { const res = await this.helpers.httpRequest({ method: 'GET', url: base, qs: { status: 'publish', per_page: 100, page, orderby: 'id', order: 'asc', _fields: 'id,slug,link,date,modified_gmt,title,content', }, json: true, returnFullResponse: true, }); totalPages = Number(res.headers['x-wp-totalpages'] || 1); posts.push(...res.body); page++; } while (page <= totalPages); return posts.map(p => ({ json: { post_id: p.id, link: p.link, date: p.date, title: p.title.rendered, html: p.content.rendered, // le nom du fichier porte la date de modification : c'est lui qui sert de clé filename: `wp-${p.id}-${p.slug}-${p.modified_gmt.replace(/[-:]/g, '')}.md`, }})); |
Réconciliation
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
const posts = $('Articles WordPress').all().map(i => i.json); const files = $('Fichiers de la base').all().flatMap(i => i.json.items ?? []); const wanted = new Set(posts.map(p => p.filename)); const present = new Set(files.map(f => f.filename)); const out = []; // Fichiers wp-* qui ne correspondent plus à aucun article publié for (const f of files) { if (f.filename?.startsWith('wp-') && !wanted.has(f.filename)) { out.push({ json: { action: 'remove', file_id: f.id, filename: f.filename } }); } } // Articles absents de la base (nouveaux ou modifiés) for (const p of posts) { if (!present.has(p.filename)) out.push({ json: { action: 'add', ...p } }); } return out; |
Si la sortie est vide, il n’y a rien à faire, et le workflow s’arrête là. Les fichiers que j’aurais ajoutés à la main dans la base, sans préfixe wp-, ne sont jamais touchés.
Préparation des fichiers
Le contenu renvoyé par WordPress est du HTML Gutenberg. Le découper tel quel, c’est vectoriser des balises. Ce nœud, en mode Run Once for Each Item (attention, ce n’est pas le même mode que les nœuds précédents : en All Items, $json ne désigne que le premier item, et je n’ai importé qu’un article au premier essai ^^), le convertit en Markdown sommaire, garde les blocs de code, et ajoute le titre et l’URL. C’est important : chaque morceau ne « sait » que ce qu’il contient. L’URL est donc répétée sous chaque intertitre, pour que la plupart des morceaux sachent de quel article ils viennent.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
const p = $json; const decode = s => s .replace(/&#(\d+);/g, (_, d) => String.fromCodePoint(Number(d))) .replace(/&#x([0-9a-f]+);/gi, (_, h) => String.fromCodePoint(parseInt(h, 16))) .replace(/ /g, ' ').replace(/</g, '<').replace(/>/g, '>') .replace(/"/g, '"').replace(/&/g, '&'); // Titre et référence calculés d'abord : on les répète sous chaque intertitre const title = decode(p.title.replace(/<[^>]+>/g, '')); const ref = `(Article : ${title}, ${p.link})`; let t = p.html .replace(/<pre[^>]*>([\s\S]*?)<\/pre>/gi, (_, c) => '\n```\n' + c + '\n```\n') .replace(/<h([2-4])[^>]*>([\s\S]*?)<\/h\1>/gi, (_, n, c) => '\n' + '#'.repeat(Number(n)) + ' ' + c + '\n' + ref + '\n') .replace(/<li[^>]*>/gi, '\n- ') .replace(/<br\s*\/?>|<\/p>|<\/div>/gi, '\n') .replace(/<[^>]+>/g, ''); // on retire les balises AVANT de décoder les entités t = decode(t).replace(/\n{3,}/g, '\n\n').trim(); const md = `# ${title}\n\nSource : ${p.link}\nPublié le : ${p.date.slice(0, 10)}\n\n${t}\n`; return { json: { filename: p.filename, title, link: p.link }, binary: { data: await this.helpers.prepareBinaryData(Buffer.from(md, 'utf8'), p.filename, 'text/markdown') }, }; |
L’ordre compte : on retire les balises avant de décoder les entités. Dans l’autre sens, un <service> dans un bloc de code deviendrait une balise, et serait supprimé.
Envoyer, puis ajouter à la base
Envoyer : POST sur http://open-webui:8080/api/v1/files/, avec un paramètre de requête process_in_background à false collé à la main dans l’URL. Body Content Type Form-Data, un paramètre de type n8n Binary File nommé file, avec data comme champ binaire d’entrée. Le paramètre process_in_background=false est essentiel : par défaut, Open WebUI répond tout de suite et traite le fichier en tâche de fond, et le nœud suivant tenterait d’ajouter à la base un fichier pas encore extrait.
Ajouter à la base : POST sur http://open-webui:8080/api/v1/knowledge/<KID>/file/add, corps JSON {"file_id": "{{ $json.id }}"}, en mode Expression. C’est à ce moment qu’Open WebUI découpe, appelle Ollama pour les embeddings, et écrit dans Qdrant.
Retirer de la base : POST sur http://open-webui:8080/api/v1/knowledge/<KID>/file/remove, corps JSON {"file_id": "{{ $json.file_id }}"}, en mode Expression lui aussi (en mode Fixed, n8n envoie littéralement {{ $json.file_id }}). Le fichier est aussi supprimé d’Open WebUI, vecteurs compris.
Pourquoi la boucle
Ma première version enchaînait directement Préparer, Envoyer et Ajouter. Sauf que n8n exécute un nœud pour tous ses items avant de passer au suivant : « Envoyer » téléversait donc les 663 articles avant que « Ajouter à la base » ne démarre. Au premier plantage en route, rien n’était rattaché à la base, les fichiers déjà envoyés restaient orphelins (vecteurs compris), et la relance repartait de zéro. Quatre essais plus tard, Qdrant avait grossi de 17 000 points, et ma base était toujours vide ^^
La boucle Loop Over Items est précisément là pour ça : chaque paquet de 5 articles est préparé, envoyé et rattaché avant le suivant, et une relance reprend là où ça s’est arrêté. Sur les nœuds d’appel, je garde en plus l’option Batching (5 items par lot, 1 000 ms entre deux lots) pour ne pas noyer Open WebUI et le GPU de mon Mac Mini.
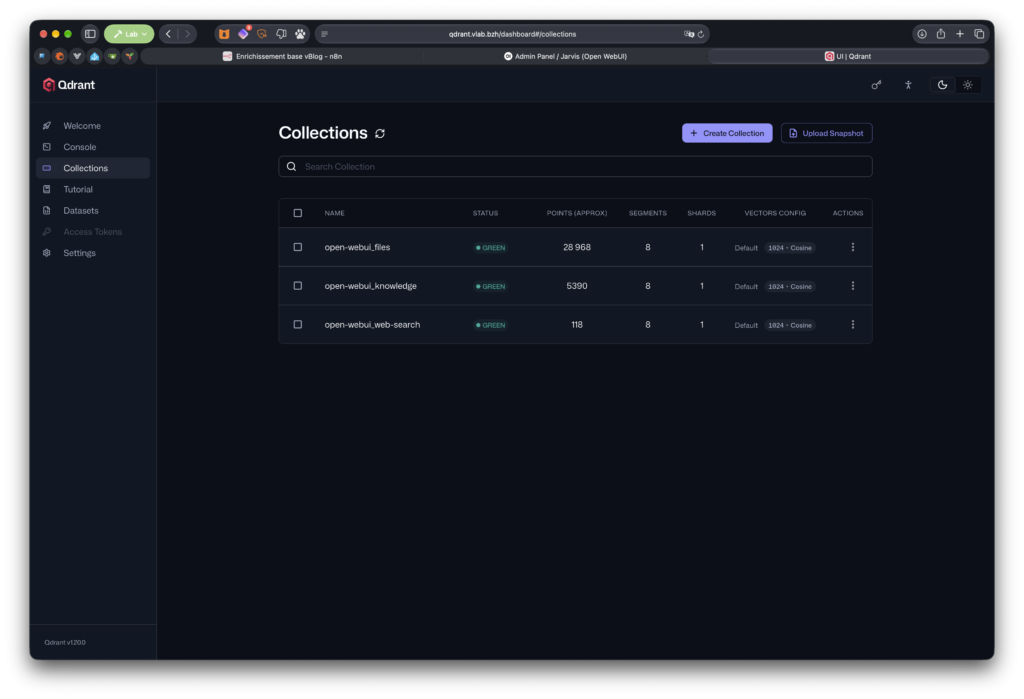
Résultat chez moi : 663 articles importés en 15 minutes environ, 669 fichiers dans la base au total, découpés en 5 390 morceaux, autant de points dans la collection Qdrant open-webui_knowledge. Et une relance juste après ne trouve plus rien à faire : la réconciliation sort 0 item, l’exécution dure quelques secondes.
Deux remarques en passant. Pendant les tests, n8n refusait d’exécuter un seul nœud (« Existing execution data is too large ») : avec 669 articles et leur HTML en mémoire, il faut lancer le workflow complet. Et pour aller plus loin, WordPress peut prévenir n8n à chaque publication via un webhook ; la réconciliation nocturne reste utile en filet de sécurité.
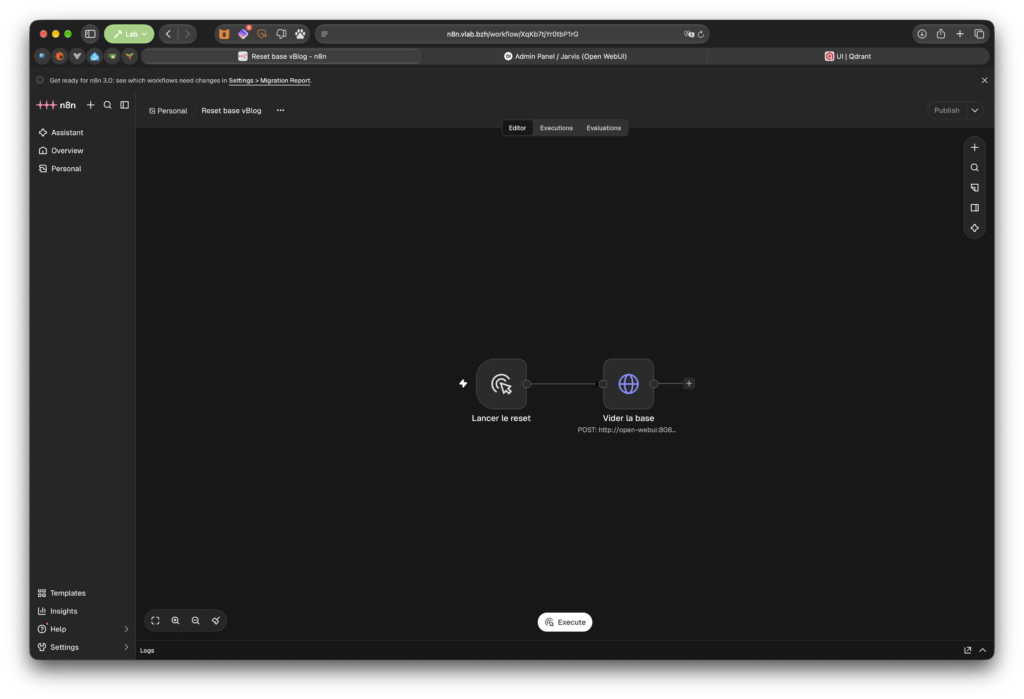
Le workflow « Reset base vBlog »
Le deuxième workflow tient en deux nœuds, et je m’en suis servi plus que prévu : chaque fois que je change la préparation des fichiers, je veux repartir d’une base propre. Supprimer la base et la recréer, c’est changer son identifiant, refaire le partage avec le groupe, et modifier toutes les URL du workflow. Open WebUI a une route pour la vider sans la supprimer : POST /api/v1/knowledge/<KID>/reset (code source). Elle efface la collection de vecteurs et les fichiers, et garde l’identifiant et les droits.
- Manual Trigger « Lancer le reset ».
- HTTP Request « Vider la base » : POST sur
http://open-webui:8080/api/v1/knowledge/<KID>/reset, même credential Bearer.
Un détail : la route ne supprime que les fichiers dont l’appelant est propriétaire (sauf pour un admin). Les fichiers ont été envoyés par n8n, c’est donc sa clé qu’il faut utiliser. Le workflow reste inactif, il ne se lance qu’à la main, et un passage d’« Enrichissement base vBlog » remet tout en place en un quart d’heure.
À noter que pour un simple changement du nom des fichiers, le reset n’est même pas nécessaire : la réconciliation voit que plus aucun fichier ne correspond, retire les anciens et ajoute les nouveaux toute seule.
Premier test du RAG
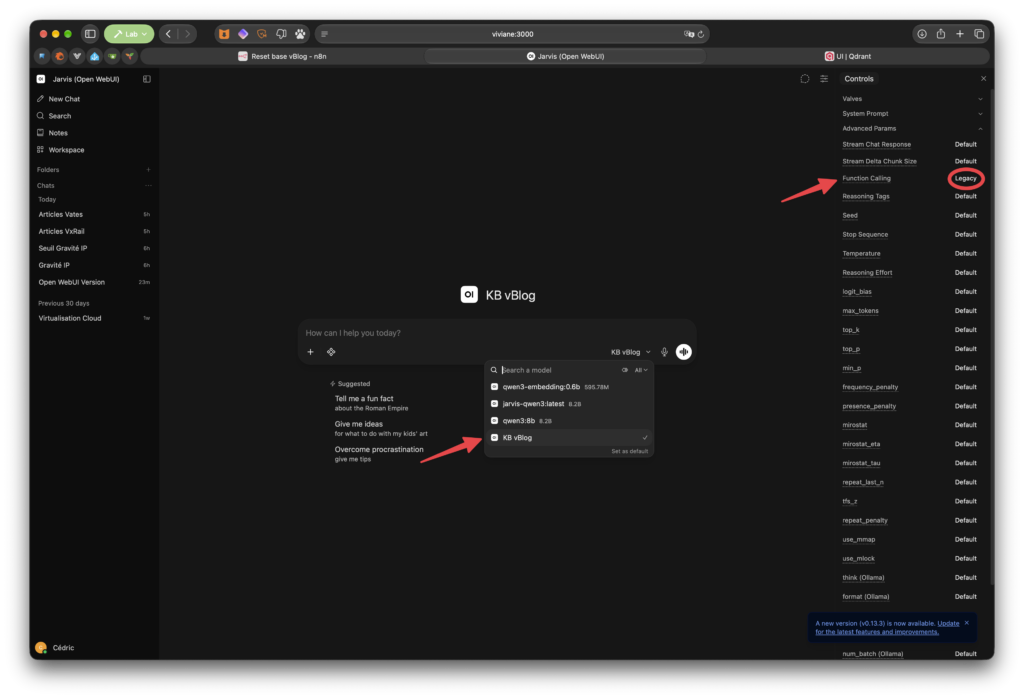
Deux façons d’utiliser la base dans Open WebUI : soit à la volée : dans une conversation, on tape # et on choisit vBlog. La base n’est utilisée que pour ce message ; soit en permanence : dans Workspace > Models, on crée un modèle KB vBlog basé sur jarvis-qwen3, auquel on attache la base vBlog. Il apparaît ensuite dans la liste des modèles, comme n’importe quel autre.
Première difficulté : dans les Advanced Params du modèle, il faut régler Function Calling sur Legacy. Sur les versions récentes d’Open WebUI, « Default » se comporte comme « Native » : les extraits de la base ne sont plus injectés dans le prompt (merci Jarvis, j’ai mis 30 minutes à comprendre ce qu’il se passait), la base est proposée au modèle comme un outil qu’il doit penser à appeler. Qwen3 8B ne l’a pas fait, et m’a répondu qu’il n’avait accès à aucun document … c’est balot :). Ce réglage est par modèle, pas par base : c’est une raison de plus pour avoir un modèle dédié au RAG.
Des questions dont je connais la réponse (oui forcément, pour vérifier)
Pour évaluer un RAG, on commence par des questions dont on connaît la réponse, et l’article qui la contient. Ce qu’on vérifie, c’est d’abord que le bon article remonte dans les citations, ensuite que la réponse est juste.
| Question | Réponse attendue | Article attendu | Résultat |
|---|---|---|---|
| À partir de combien d’événements par IP la gravité passe-t-elle à « moyenne » ? | 10 | Chapitre 2 | Juste, chapitre 2 cité |
| Pourquoi Ollama ne tourne-t-il pas dans un conteneur ? | Accès au GPU du Mac (Metal) | Chapitre 1 | Raté : le chapitre 1 est cité, mais pas le bon passage, ainsi que d’autres articles |
| Quelle version d’Open WebUI ai-je installée ? | v0.12.5 | Chapitre 1 | Juste |
| Est-ce que tu trouves des articles sur VxRail ? | Les articles existants, sans en inventer | Plusieurs | Des titres et des URL inventés |
Le bilan est mitigé, et c’est normal : la recherche fonctionne, mais un modèle de 8 milliards de paramètres a besoin d’être cadré pour ne pas halluciner (le fameux « harness »). Le réglage du template RAG, de la température et le test d’autres modèles font l’objet d’une section entière dans le chapitre 4. En attendant, la règle du chapitre 1 tient toujours : n’accordez jamais une confiance aveugle à la réponse. Cliquez sur la citation, et allez lire l’article (la base, quoi)
Sécurité
Avec le RAG, on fait entrer dans le contexte du modèle du texte qu’on n’a pas écrit au moment de la question. C’est la porte ouverte à l’injection de prompt : un texte qui contient des instructions, que le modèle peut prendre pour les vôtres. Ici, c’est moi qui écris les articles, et les commentaires ne sont pas importés : il faut que ça reste le cas. Le jour où on indexe du contenu tiers (des pages web, des tickets, des mails), il faut le traiter avec méfiance. On en reparle au chapitre 4, avec les logs, qui eux sont écrits par l’attaquant.
Et toujours le rappel du chapitre 1 : Ollama n’a pas d’authentification. Le port 11434 de jarvis ne doit être joignable que depuis le LAN du lab.
Les soucis qui ont complexifié mon lab (et ma compréhension)
| Symptôme | Cause | Correctif |
|---|---|---|
Les variables RAG_* du compose n’ont aucun effet | PersistentConfig : seule la première valeur compte | Admin Panel > Settings > Documents |
| Impossible de créer une clé d’API | Toggle global, permission de groupe, membre du groupe au sein de OpenWebUI | Les trois, et se reconnecter |
| L’ajout à la base est refusé (« permission ») | Base non partagée avec le compte n8n | Access : groupe en Write |
| Un seul article importé sur cinq | Code en mode Run Once for All Items | Run Once for Each Item |
| Import arrêté à 333 articles | Too many open files dans Open WebUI | ulimits nofile à 65536 |
| Qdrant grossit mais la base reste vide | n8n envoie tout avant de rattacher quoi que ce soit | Loop Over Items par paquets de 5 |
| « Duplicate content detected » à la relance | Seule la première page de 30 fichiers est lue | Pagination sur « Fichiers de la base » |
| Le modèle dit n’avoir accès à aucun document | Function Calling en Default (= Native) | Legacy sur le modèle RAG |
Conclusion
Un modèle de 8 milliards de paramètres, ça se tient en laisse
Je vais être honnête : la première version de ce RAG m’a donné du fil à retordre. Qwen3 8B a l’air sûr de lui, il répond assez vite (sur un Mini M4 de 16 Go), en bon français… et il m’a cité avec aplomb des articles de vBlog qui n’ont jamais existé, avec des URL qui renvoient une 404. Un peu gonflé le machin ! je ne compte plus les Rognotudju :). Rappelez-vous, ce n’est pas un bug de Qwen, c’est la nature d’un petit modèle : quand il ne trouve pas, il complète, et il le fait avec le même ton que quand il sait.
En creusant, j’ai découvert que l’outillage autour du modèle, le « harness », pèse autant que le modèle lui-même. Le template RAG par défaut d’Open WebUI autorise explicitement le modèle à répondre « de mémoire » si le contexte ne contient pas la réponse : pour un 8B, c’est une invitation à halluciner. Le mode Function Calling « Default » n’injecte même plus les extraits dans le prompt. Et quand je lui ai demandé d’écrire lui-même les liens vers les articles, il a recopié de travers ou fabriqué ce qui manquait.
La piste, ce n’est pas forcément un modèle plus gros, c’est un cadre plus serré : le mode Legacy pour forcer l’injection des extraits, un template RAG qui interdit de sortir du contexte et impose de dire « je n’ai pas trouvé », une température basse, et des sources affichées par Open WebUI à partir de ce qui a réellement été retrouvé dans Qdrant, plutôt que des liens écrits par le modèle. On ne demande pas à un 8B de réfléchir à notre place : on lui donne des consignes courtes, précises, sans ambiguïté, et on vérifie. Avec un modèle local de cette taille, le prompt n’est pas un détail, c’est la moitié du travail. Du coup, une formation à rédiger des prompt ? ce ne serait pas une mauvaise idée dans l’absolu :).
Bon ! Chouetos mais on fait quoi maintenant ?
On a maintenant une base de connaissances qui suit le blog toute seule, et un Jarvis qui sait y chercher. Tout tourne en local, sauf la lecture de l’API publique de WordPress. J’aurais pu vous la proposer en lab pour que vous voyez comment ça répond vraiment, mais vu la machine sur lequel ça tourne … ça aurait été une catastrophe en matière de perfs ! Si vous avez une H100 80 Go qui traine … ^^
Au chapitre 4, il y aura deux gros morceaux. D’abord le réglage fin : template RAG, utilisation de la température, nombre d’extraits, recherche hybride web+locale, et la comparaison de Qwen3 8B avec d’autres modèles qui tiennent sur les 16 Go de jarvis. Ensuite MCP : n8n expose LogStream comme un serveur d’outils, et Qwen pourra aller regarder les logs tout seul quand la question le demande.
Pour terminer, c’est un des lab les plus longs que j’ai eu l’occasion de construire (au moins 2 week-end quasi complets). l’IA c’est compliqué mais c’est passionnant ! En attendant, un ingénieur ou technicien averti en vaut largement deux : un Modèle/RAG se juge à l’exactitude de ses sources, pas sur l’aplomb de ses réponses ^^
Références :
– Chapitres précédents : chapitre 1, Ollama et Open WebUI, chapitre 2, n8n et LogStream
– Ollama : embeddings, FAQ, qwen3-embedding, bge-m3, nomic-embed-text
– Open WebUI : variables d’environnement, API
– Qdrant : image Docker
– n8n : Loop Over Items, HTTP Request
– WordPress : API Posts, pagination