Dans le chapitre 1, on a monté une petite pile d’IA 100 % locale : Ollama pour faire tourner Qwen3 8B, Open WebUI pour une interface web plus confortable que la ligne de commande, et SearXNG pour donner au modèle la possibilité de chercher sur le web. C’est sympa, mais pour l’instant, notre LLM ne fait que discuter et pas grand-chose d’autre. Aujourd’hui, on va lui donner des capacités de m’avertir.
L’objectif c’est de continuer à progresser ensemble sur l’exploitation et le potentiel d’une IA intégrée avec des outils ad-hoc. Pour le coup on va utiliser une fonction qui me manque (qui manque à tout le monde qui n’a ni les moyens ni même la structure pour pouvoir lire les logs, les analyser, voire les corréler à d’autres signaux faibles pour anticiper et dans le meilleur des cas, prévenir tout incident de sécurité ou d’exploitation). C’est le principe d’un workflow qui va récupérer en live les logs des sources importantes pour vous, les passer à la molinette de notre IA locale et éventuellement nous notifier en cas de suspicion de certains logs.
Spoiler : ça ne s’est pas passé exactement comme prévu. Mon petit Qwen s’est pris les pieds dans le tapis plus d’une fois (il a même voulu me bloquer moi-même, je vous raconte ça plus bas), et c’est justement ce qui rend l’exercice intéressant. Vous allez voir que la vraie leçon n’est pas « comment brancher un LLM sur des logs », mais « qu’est-ce qu’on lui laisse faire, et qu’est-ce qu’on ne lui laisse surtout pas décider ».
Pour ça, nous allons passer par un outil dont tout le monde a déjà entendu parler je pense : n8n.
Pourquoi n8n
n8n fait beaucoup de bruit en ce moment, et ce n’est pas du buzz gratuit : l’outil s’impose peu à peu chez les Ops, qui s’en servent pour structurer des productions automatiques, par exemple la construction automatisée d’architectures ou d’environnements de VM. Mais aussi pour mettre en place des workflows de « command & control » comme on dit dans le jargon 🙂
Le principe est assez simple : on assemble des nœuds via une interface graphique (un déclencheur, des filtres, un appel au modèle, une notification) et on obtient une automatisation sans écrire des pages de code. Ollama avec Qwen3 devient le cerveau, n8n l’orchestrateur qui enchaîne les actions autour.
Déploiement en Docker Compose et configuration
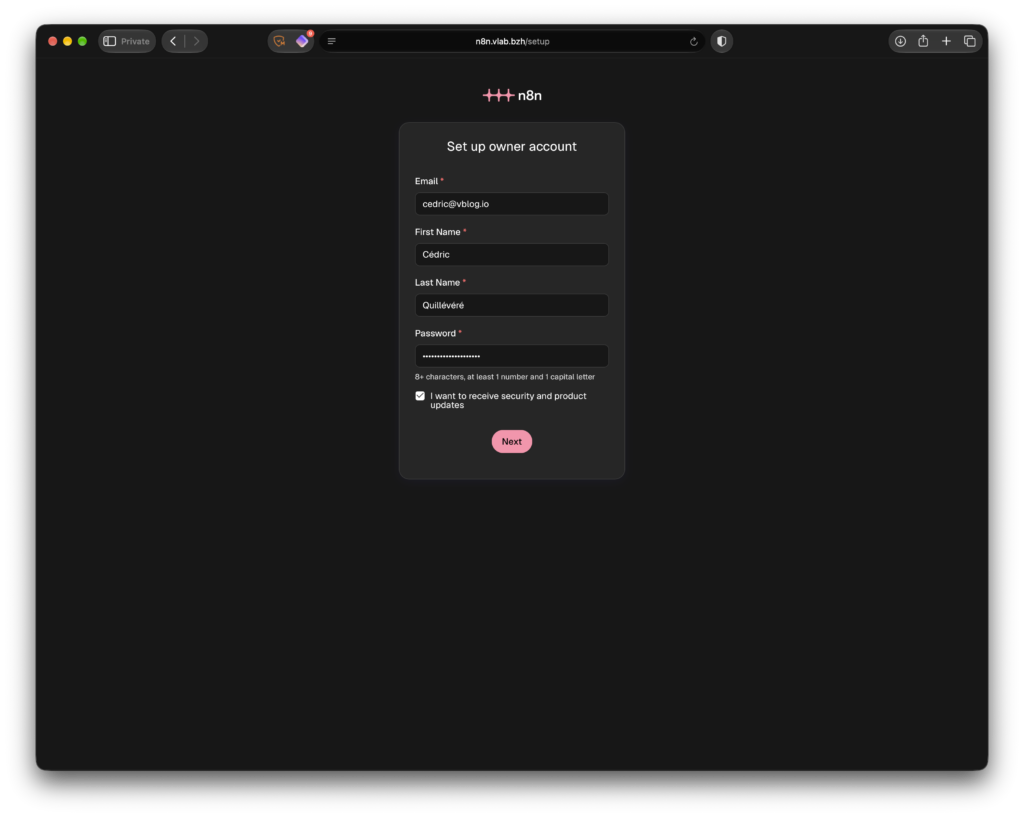
Comme souvent ici, tout passe par un docker-compose. L’idée est de déployer n8n à côté de la pile existante, en gardant en tête qu’Ollama tourne en natif sur le Mac mini, pas dans Docker : n8n le joint donc par l’adresse IP du Mac mini (port 11434) et non par un nom de service, localhost dans un conteneur désignant le conteneur lui-même. On persiste les données dans un volume, on renseigne les variables d’environnement utiles (fuseau horaire, URL du webhook), puis un docker compose up -d et l’interface répond sur son port. Si vous avez des soucis avec le docker-compose, n’hésitez pas à le mettre en commentaire, globalement, ça s’installe très simplement. Vous obtenez une licence « pro individuelle » gratuite pour le mail d’inscription initiale, donc mettez bien un mail correct 🙂
Pour ceux qui veulent le copier-coller, voici mon compose (derrière Traefik, comme le reste de mes services). Les deux variables N8N_RUNNERS_* à la fin du bloc environment ne sont pas là par hasard : elles m’ont fait perdre un bon moment, j’y reviens au premier nœud de code.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 |
services: n8n: image: docker.n8n.io/n8nio/n8n container_name: n8n restart: unless-stopped env_file: ./.env ports: - "5678:5678" volumes: - n8n-data:/home/node/.n8n environment: - N8N_RUNNERS_ENABLED=true - N8N_RUNNERS_MODE=internal networks: - traefik-net volumes: n8n-data: networks: traefik-net: external: true |
Premier test : n8n parle à Qwen
C’est parti pour notre premier workflow avec un nœud Ollama pointé sur Qwen et lui envoyer une question simple. Si la réponse revient, la plomberie est bonne et on peut passer aux choses sérieuses. Je ne vais pas vous faire un tuto de n8n ici car ça nécessiterait des chapitres entiers, mais on va rester simple avec des images et des workflows compréhensibles (j’espère :))
Dans n8n, un workflow est un canevas : on pose des nœuds, on tire des fils entre eux, et chaque nœud passe des « items » (du JSON) au suivant. Pour parler à un modèle, on utilise un nœud Basic LLM Chain, auquel on branche en dessous un Ollama Chat Model : le premier gère le prompt, le second choisit le cerveau :
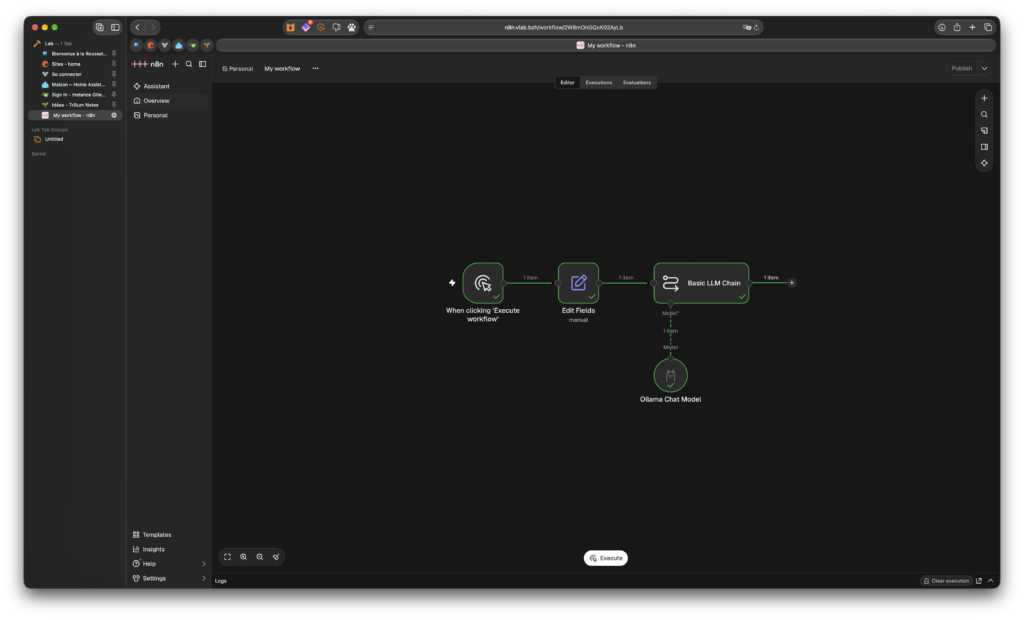
L’identifiant Ollama est tout simple : l’adresse du Mac mini avec le port 11434. Il se trouve dans les paramètres du nœud. Premier signe que ça a l’air de fonctionner correctement : le champ Model se remplit tout seul avec la liste de mes modèles (j’ai pris jarvis-qwen3, le Qwen3 8B passé à la moulinette de mon Modelfile du chapitre 1). Si n8n arrive à lister les modèles, c’est qu’il voit Ollama, inutile d’aller plus loin pour s’en convaincre.
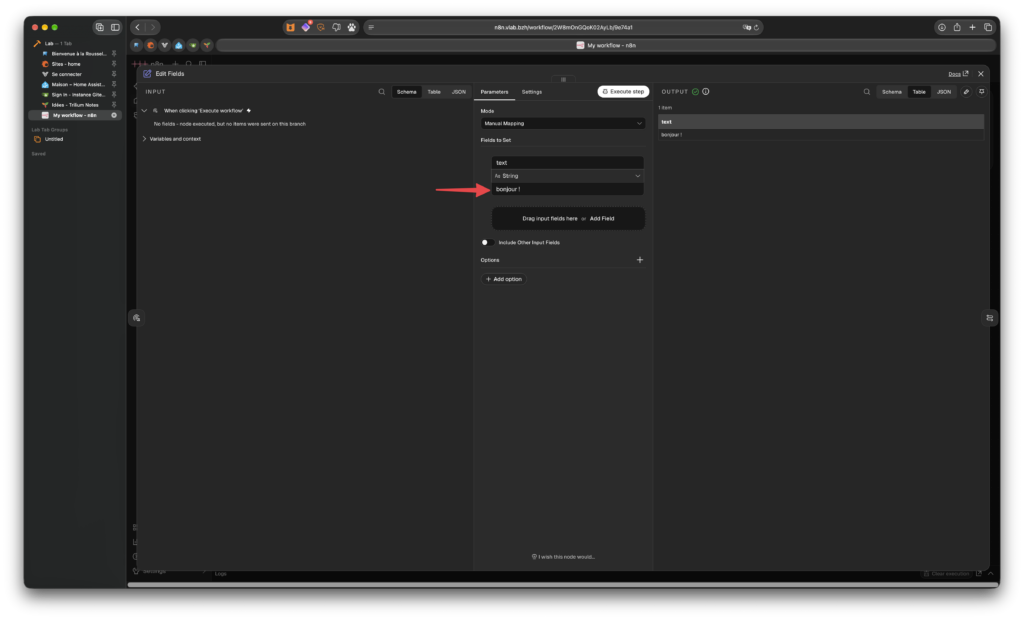
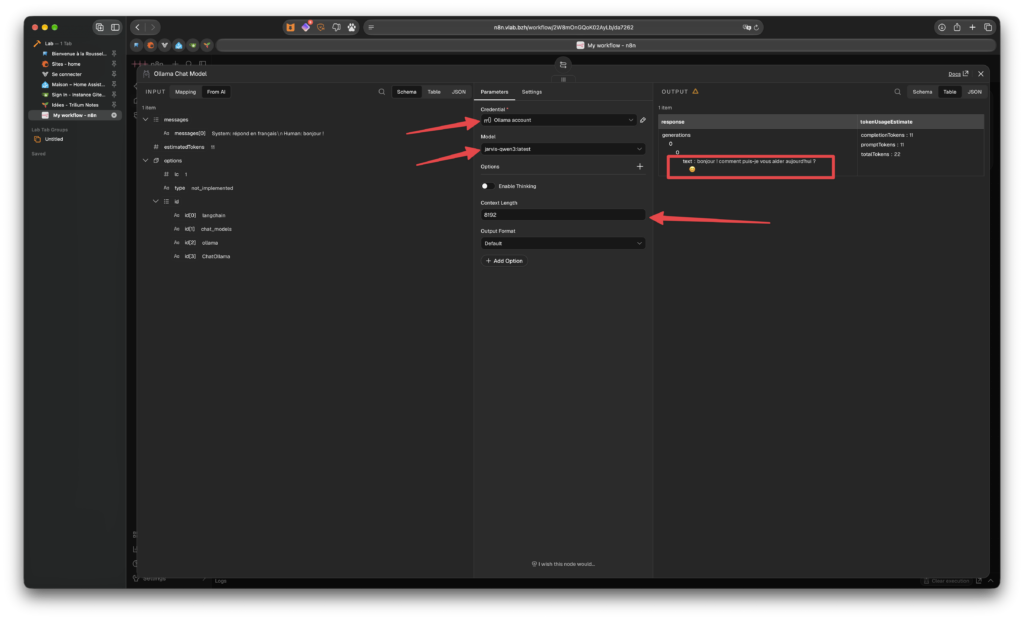
Un réglage à ne pas oublier, qu’on avait déjà croisé au chapitre 1 : la Context Length. Ollama a par défaut une fenêtre de contexte courte, et un modèle qui ne voit pas tout le texte répond n’importe quoi. Je l’ai passée à 8192.
Le workflow d’analyse de logs
On va complexifier un peu les choses : faire analyser des logs par le LLM local, pour qu’il comprenne le contexte d’une anomalie au lieu de se contenter d’un motif dans une expression régulière.
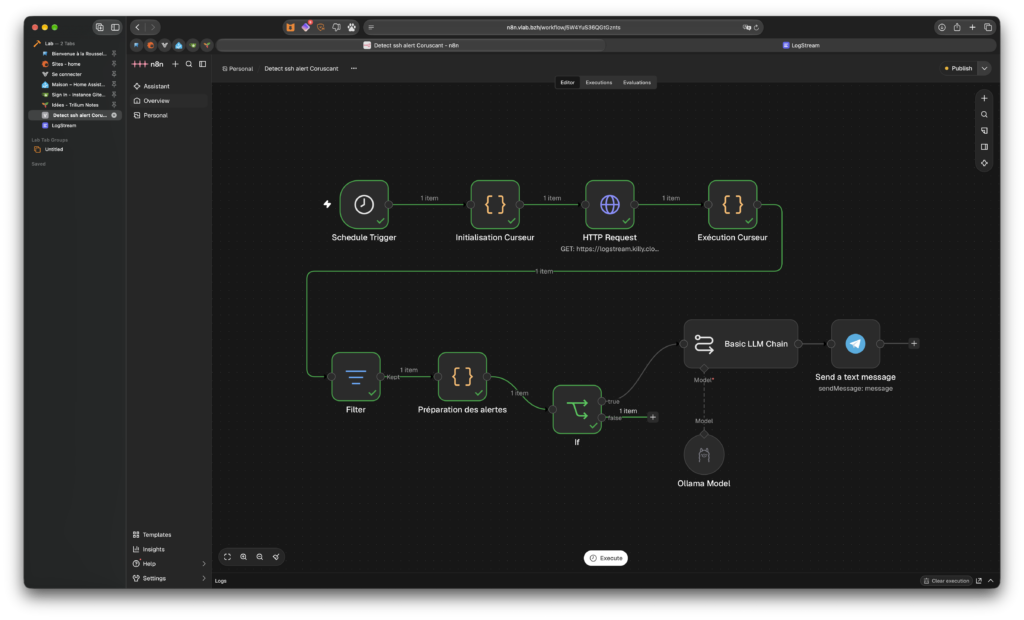
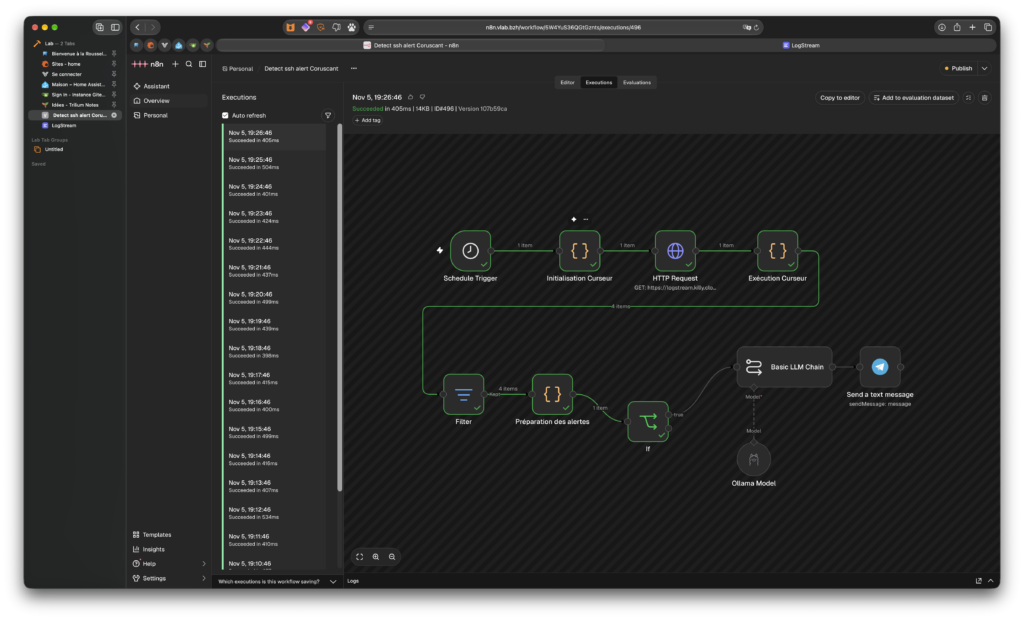
Voilà le plan que j’avais en tête au départ, le workflow tient en cinq étapes :
- Un déclencheur planifié n8n (Schedule Trigger) interroge LogStream toutes les minutes et récupère les nouveaux logs.
- Un filtre écarte le bruit, par mots-clés ou par niveau de sévérité. C’est essentiel : on ne sollicite pas un modèle qui tourne sur un Mac mini sur chaque ligne, ce serait totalement impossible (même pour des IA cloud type Mistral, Claude ou OpenAI … vous exploseriez vos factures et ça n’irait pas assez vite de toute façon).
- Le nœud Ollama reçoit la ligne suspecte, avec quelques lignes de contexte avant et après.
- Un prompt strict impose une sortie en JSON : cause probable, gravité, action suggérée (c’est notamment là qu’il faudra être extrêmement précis, merci Jarvis).
- Une notification (pour nous ce sera Telegram, simple et rapide avec BotFather) transmet le résultat et notifie l’admin (moi en l’occurrence).
Le point clé encore une fois c’est le cadrage. Un petit modèle local peut se tromper ou inventer sur des logs obscurs. En lui imposant un format de sortie fixe et un rôle précis, on réduit fortement les écarts, et n8n peut valider le JSON avant d’aller plus loin (ce qui rajoute encore au filtrage).
Eh bien je me suis trompé. Les étapes 3 et 4 ne se sont pas du tout passées comme ça, et vous allez voir pourquoi : mon Qwen ne respecte pas le JSON qu’on lui demande, et pire, il invente (héhé … l’hallucination des IAs …). On y vient, mais d’abord il faut une source de logs.
Brancher LogStream
Il me fallait une source de logs. Pourquoi pas la mienne après tout ! : LogStream, mon puits de logs en Go que je vous ai présenté il y a quelques semaines … on a l’impression que tout a été planifié, c’est fou 🙂 :). Problème, il reçoit les logs (notamment en syslog sur le port 514) mais n’expose pas d’API pour les ressortir. Qu’à cela ne tienne : je lui ajoute une fonction de lecture.
Ça donne une route GET /api/v1/logs, en lecture seule, protégée par un jeton d’API que l’on crée dans Paramètres > API de LogStream (il n’est affiché qu’une fois, LogStream n’en garde que l’empreinte). Quatre paramètres suffisent : query pour filtrer (c’est du LogsQL, le langage de VictoriaLogs, par exemple app:"sshd-session") ; since pour dire à partir d’où on veut les logs ; limit pour en borner le nombre (1000 par défaut) ; et lag, qui évite de renvoyer les logs trop frais, encore en route (30 secondes par défaut).
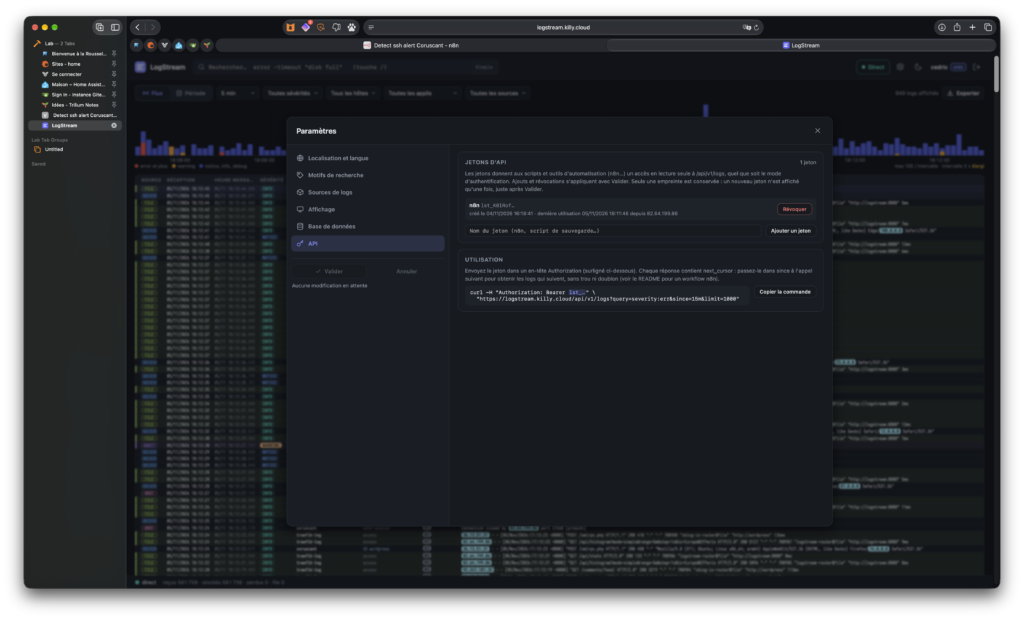
Et surtout, il y a le curseur. Chaque réponse contient un next_cursor, et il suffit de le renvoyer à la requête suivante pour repartir exactement là où on s’était arrêté. Pourquoi un curseur ? Parce que n8n n’écoute pas, il interroge : toutes les minutes il demande « quoi de neuf ? ». Si je redemande à chaque fois « les 15 dernières minutes », je relis chaque log une quinzaine de fois (et Qwen l’analyse quinze fois). Si je demande « la dernière minute », un passage en retard de quelques secondes me fait perdre des logs, ce qui est pire en sécurité. Le curseur, c’est un marque-page : chaque log est lu une fois, sans trou. Une simple heure ne suffit pas non plus, car plusieurs logs peuvent partager la même milliseconde, ce que le curseur de LogStream gère.
Pour le volume, on filtre côté LogStream où on regroupe les lignes par lots de quelques secondes, afin de ne pas inonder n8n ni le modèle. Et comme pour le reste de LogStream, l’évolution a été réalisée avec mon désormais célèbre majordome ^^.
Construire le workflow, nœud par nœud
Le schedule trigger
Le Schedule Trigger est le plus simple : un intervalle, et c’est tout. Je l’ai réglé sur une minute. Attention, à l’ouverture, par défaut le nœud propose « Hours » et pas « Minutes » : si on ne touche à rien, le workflow ne passe qu’une fois par heure et chaque passage relit toute l’heure, ce qui change beaucoup de choses sur les seuils, j’y reviens.
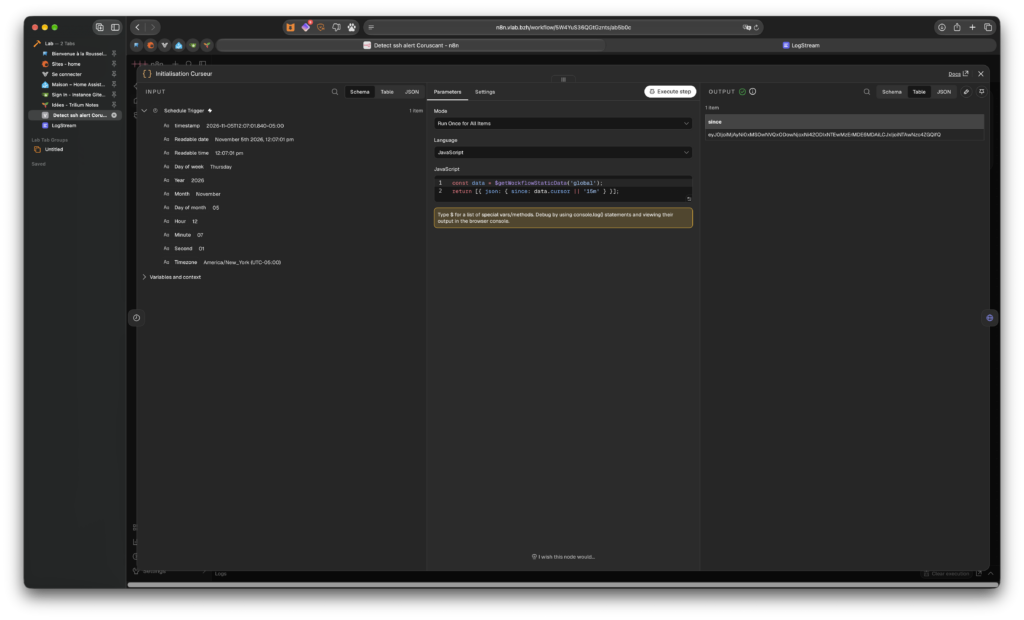
Le curseur, partie 1 : un peu de JavaScript
C’est ici que j’ai mis les mains dans le code, et je précise que le JavaScript, je ne connais pas du tout. Jarvis me l’a écrit et surtout expliqué, alors je vous explique à mon tour. Premier nœud Code, que j’ai appelé « Initialisation Curseur » :
|
1 2 |
const data = $getWorkflowStaticData('global'); return [{ json: { since: data.cursor || '15m' } }]; |
Ligne 1 : n8n a une petite mémoire propre à chaque workflow, qui survit d’une exécution à l’autre (à condition que le workflow soit publié, on y revient). On la range dans une variable appelée data. Ligne 2 : on renvoie un item, un petit objet avec un seul champ, since. Sa valeur est data.cursor s’il existe, sinon (|| se lit « ou sinon ») 15m, c’est-à-dire « les 15 dernières minutes ». Au tout premier passage, la mémoire est vide, donc on démarre sur 15 minutes ; ensuite, on reprendra là où le dernier passage s’est arrêté. Les crochets et les accolades autour du return ne sont pas décoratifs : n8n attend toujours une liste d’items, et chaque item doit avoir un champ json.
L’oubli du task runner. Premier plantage : mon nœud Code est devenu rouge avec un joli « Task request timed out ». Les versions récentes de n8n n’exécutent plus le code dans le processus principal, mais dans un « task runner » séparé. Mon compose n’en avait pas, donc le code attendait un exécutant qui n’existait pas. Les nœuds HTTP ou Schedule, eux, n’en ont pas besoin, d’où le fait que tout marchait jusque-là. La correction tient en deux variables d’environnement (celles de mon compose plus haut) : N8N_RUNNERS_ENABLED=true et N8N_RUNNERS_MODE=internal, puis un docker compose up -d. Le runner démarre alors dans le même conteneur. Il existe aussi un mode externe, avec un second conteneur n8nio/runners : c’est plus propre pour la production (le code est isolé de n8n et de ses identifiants), mais ça fait une pièce de plus à maintenir. Pour un lab, l’interne fait très bien l’affaire.
L’appel à LogStream
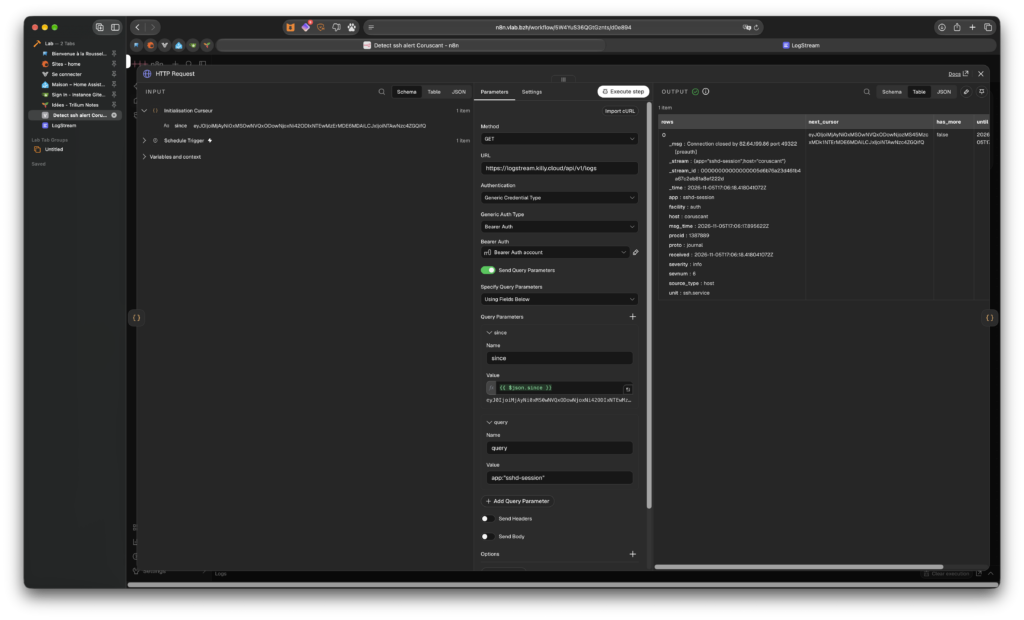
Ensuite, le HTTP Request. Méthode GET, l’URL de l’API de LogStream, et pour l’authentification un identifiant de type Bearer Auth, dans lequel on colle uniquement le jeton (n8n ajoute tout seul le mot Bearer). Petite astuce de noob : je n’ai pas trouvé de menu « Credentials » dans la barre latérale de cette version. En réalité, on crée l’identifiant directement depuis le nœud qui en a besoin, via « Create new credential ».
Puis les paramètres de requête, et là j’ai fait la bêtise classique : j’avais ajouté les paramètres sans activer l’interrupteur Send Query Parameters. Résultat, n8n appelait l’API sans aucun filtre, et je recevais 1000 logs de tout (accès web, noyau, applications) en niveau info. Une fois activé, on a deux paramètres : query et since. Pour since, la valeur est une expression, {{ $json.since }}, qui va chercher le champ produit par le nœud précédent (15m).
Pour mon test, j’ai commencé par ne regarder que les attaques SSH, avec app:"sshd-session" : c’est là que se promènent les robots qui essayent des comptes comme root ou adm sur tout ce qui répond sur le port 22.
Le curseur, partie 2 : sortir les logs un par un
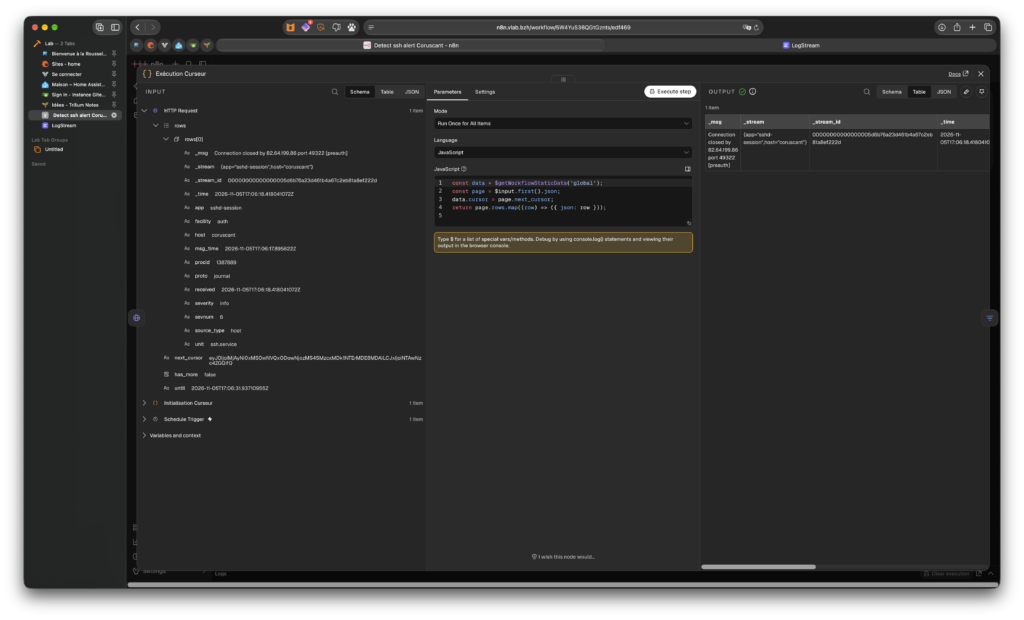
Deuxième nœud Code, « Exécution Curseur », qui enregistre le marque-page et éclate la réponse :
|
1 2 3 4 |
const data = $getWorkflowStaticData('global'); const page = $input.first().json; data.cursor = page.next_cursor; return page.rows.map((row) => ({ json: row })); |
Ligne 1 : on retrouve la mémoire du workflow. Ligne 2 : $input.first().json est la réponse du HTTP Request, qu’on appelle page. Ligne 3 : on range dans la mémoire le next_cursor de cette réponse, c’est notre marque-page pour la minute suivante. Ligne 4 : page.rows est la liste des logs ; .map(...) applique la même transformation à chacun, qui consiste à en faire un item à part entière. À la sortie, au lieu d’un gros paquet, n8n a un item par ligne de log, ce qui permet ensuite de les filtrer et les compter.
Le filtre, et la complexité de l’expression
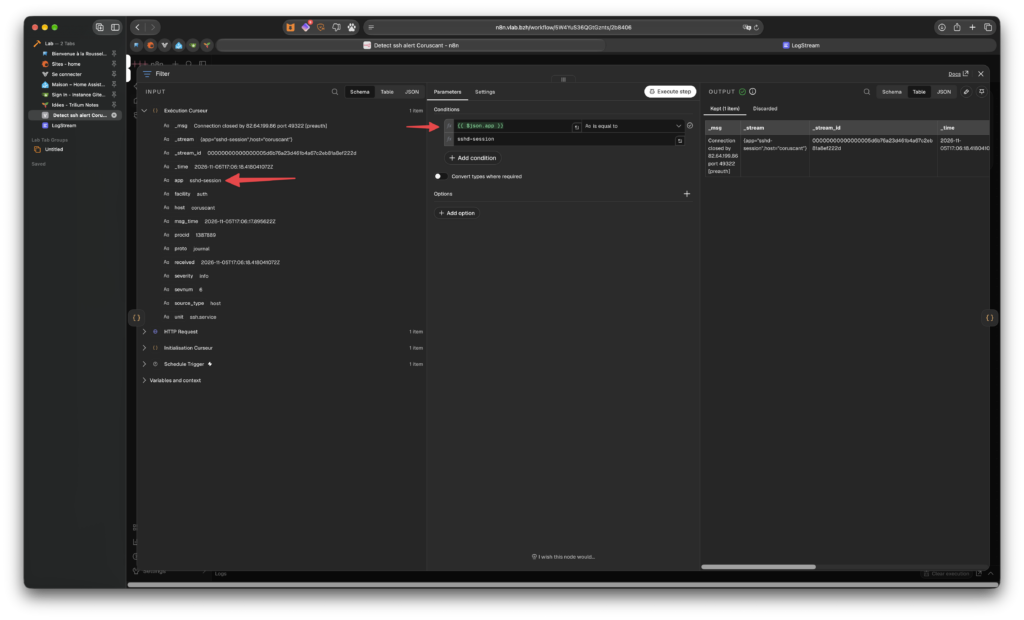
Maintenant que les logs sont des items, le nœud Filter. Je voulais garder uniquement les lignes dont l’application contient sshd-session. Et j’ai tout jeté, 51 items sur 51 à la poubelle. La raison : dans le champ de gauche, j’avais tapé app en texte brut, donc n8n comparait le mot « app » à sshd-session, évidemment faux à chaque fois. Dans n8n, un texte brut est un texte brut, et pour lire la valeur d’un champ il faut une expression, {{ $json.app }} (ou glisser le champ depuis la colonne Input, plus simple quand on débute comme moi). Même piège avec la sévérité : sevnum est un niveau numérique de 0 (le pire, emerg) à 7 (debug), et « erreur ou plus grave » se dit donc sevnum inférieur ou égal à 3, en activant « Convert types where required » parce que le champ arrive sous forme de texte.
Au final, ce filtre ne sert plus à grand-chose puisque LogStream filtre déjà à la source avec query, mais c’est un bon exercice, et filtrer le plus tôt possible reste la règle (inutile de transporter 1000 lignes pour en garder 10).
Préparer l’output de notification, n8n compte, Qwen résume
Voici le cœur de l’affaire. Ma première idée était d’envoyer les 50 dernières lignes brutes à Qwen en lui demandant d’en tirer un JSON. Je vous épargne les détails : ça ne marche pas (j’y reviens juste après). La solution a été de faire faire tout le travail « mathématique » par du code, et de ne laisser au modèle que ce qu’un modèle sait bien faire : écrire une phrase.
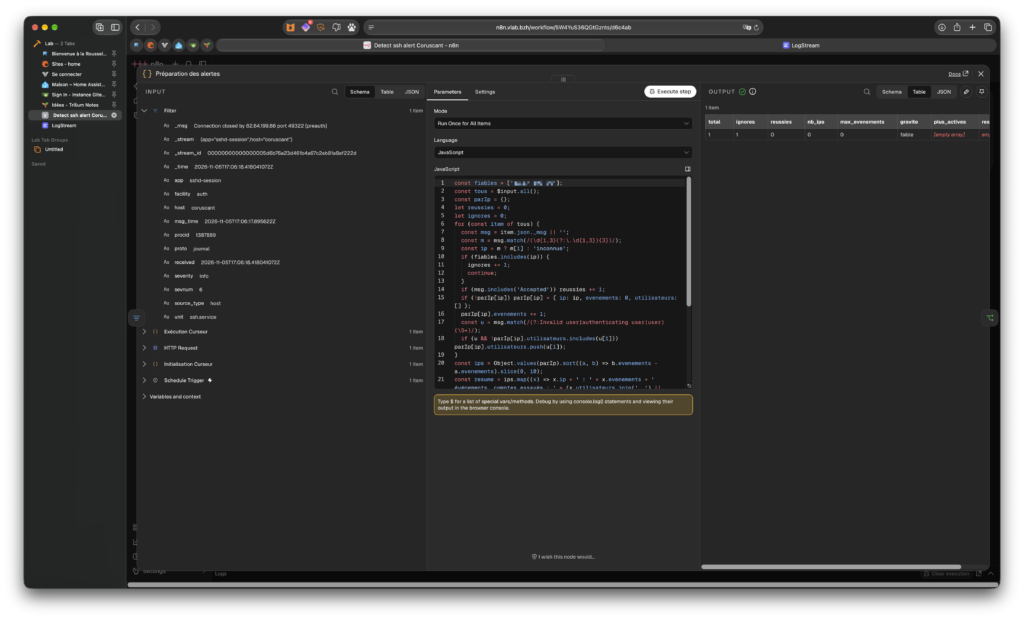
Troisième nœud Code, « Préparation des alertes » :
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 |
const fiables = ['203.0.113.10']; const tous = $input.all(); const parIp = {}; let reussies = 0; let ignores = 0; for (const item of tous) { const msg = item.json._msg || ''; const m = msg.match(/(\d{1,3}(?:\.\d{1,3}){3})/); const ip = m ? m[1] : 'inconnue'; if (fiables.includes(ip)) { ignores += 1; continue; } if (msg.includes('Accepted')) reussies += 1; if (!parIp[ip]) parIp[ip] = { ip: ip, evenements: 0, utilisateurs: [] }; parIp[ip].evenements += 1; const u = msg.match(/(?:Invalid user|authenticating user|user) (\S+)/); if (u && !parIp[ip].utilisateurs.includes(u[1])) parIp[ip].utilisateurs.push(u[1]); } const ips = Object.values(parIp).sort((a, b) => b.evenements - a.evenements).slice(0, 10); const resume = ips.map((x) => x.ip + ' : ' + x.evenements + ' événements, comptes essayés : ' + (x.utilisateurs.join(', ') || 'aucun')).join('\n'); const maxEvenements = ips.length ? ips[0].evenements : 0; let gravite = 'faible'; if (reussies > 0) { gravite = 'haute'; } else if (maxEvenements >= 10) { gravite = 'moyenne'; } return [{ json: { total: tous.length, ignores: ignores, reussies: reussies, nb_ips: Object.keys(parIp).length, max_evenements: maxEvenements, gravite: gravite, plus_actives: ips, resume: resume } }]; |
Ça fait peur au premier coup d’œil, mais c’est une suite de petites idées simples. (L’adresse 203.0.113.10 est une adresse d’exemple, à remplacer par la vôtre.) Je vous les prends dans l’ordre.
D’abord fiables : une liste d’adresses à ne jamais compter, la mienne et celles de mes outils. C’est une leçon que j’ai apprise à mes dépens : dans mes logs, une seule adresse pesait 117 lignes sur 201 en une heure, et c’était mon IP. Qwen n’a aucun moyen de le savoir, mais le code, si. Ensuite la boucle for (const item of tous) : pour chaque log, on cherche l’adresse IP avec une expression régulière (le match(...), qui cherche quatre groupes de chiffres séparés par des points). Si l’adresse est dans fiables, on note qu’on l’a ignorée (ignores) et continue passe directement à la ligne suivante. Sinon, on regarde si le message contient le mot Accepted, qui est le seul signe d’une vraie connexion réussie, et on compte. Puis on range l’événement dans une case au nom de l’IP (parIp), avec un compteur et la liste des comptes essayés (les root, ubnt, michael…). Après la boucle, on trie les IP de la plus active à la moins active (sort), on garde les 10 premières (slice), et on fabrique un petit texte récapitulatif (resume).
Et enfin la gravité, que le code décide : au moins une connexion réussie, c’est « haute » ; sinon, si une même adresse a fait 10 événements ou plus dans le lot, c’est « moyenne » ; sinon « faible ». Ce seuil, je l’ai mesuré plutôt que deviné. Mes premiers messages étaient tous en gravité « moyenne » avec un seuil de départ à 20, ce qui n’a aucun sens pour du bruit ordinaire. Alors j’ai découpé 24 heures de logs SSH minute par minute (ma propre IP mise de côté) : la plus grosse rafale d’une seule adresse est de 12 événements en une minute, et une rafale de 10 ou plus ne s’est produite que 3 fois dans la journée. Avec un passage chaque minute, un seuil à 10 donne donc environ trois alertes par jour : assez pour que ce soit un signal, pas assez pour qu’on arrête de les lire. Attention, ce seuil n’a de sens que par rapport à la durée d’un passage : si votre workflow ne passe qu’une fois par heure, la même règle se déclenche à chaque fois, il faut alors un seuil bien plus haut.
Ha oui, tant que j’écris … oui, je suis d’accord, pour un ssh, un petit fail2ban et c’est réglé, mais il fallait bien trouver quelque chose de simple et rapide à décrire pour vous expliquer un peu « ma » logique sur n8n et l’exemple classique d’usage d’un LLM local 🙂
Un dernier point, à assumer en connaissance de cause : les adresses de la liste fiables sont ignorées y compris pour les connexions réussies. Sur mes 24 dernières heures, il y a une seule connexion réussie (root, par clé publique, depuis chez moi), que mon workflow ne voit donc pas. Si quelqu’un utilisait ma clé depuis ma propre adresse, je n’aurais aucune alerte. Pour un labo, c’est un compromis que j’assume. Selon la doctrine de sécurité d’une entreprise, ce ne serait pas forcément acceptable : on voudrait au minimum journaliser, voire notifier, toute connexion root (sans sudo ??), même depuis une adresse de confiance.
Décider s’il faut réveiller Qwen
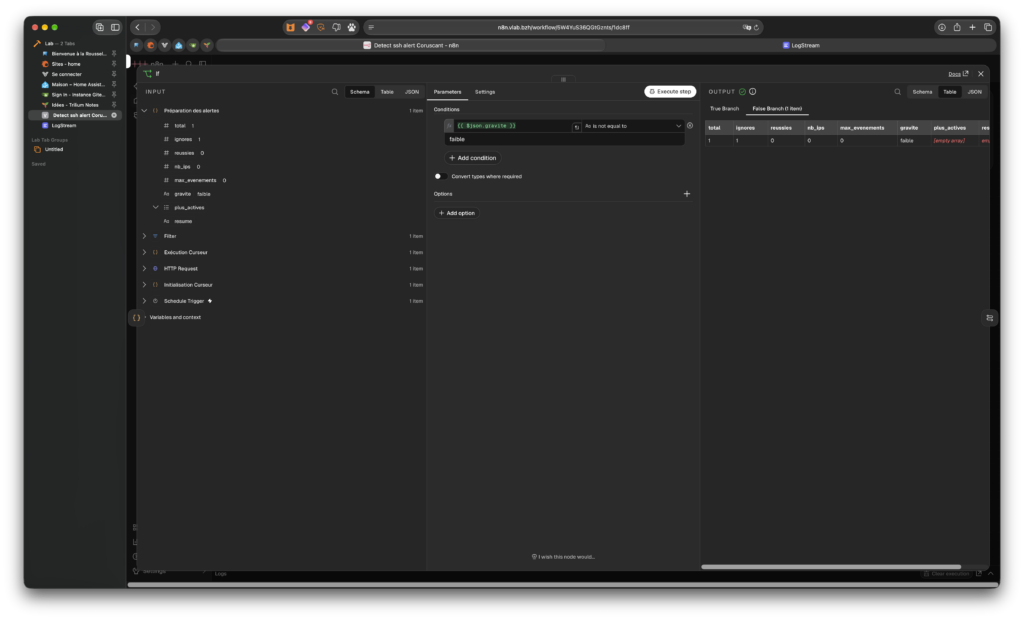
Un nœud If tout bête : si {{ $json.gravite }} est différent de faible, on continue vers Qwen et Telegram ; sinon, il ne se passe rien. C’est aussi le meilleur moyen de ne pas faire tourner le Mac mini pour rien : quand tout est calme, Qwen n’est même pas appelé. (Attention au câblage, la sortie « true » doit mener à Qwen, c’est plus facile de les inverser qu’on ne le croit.)
Quand Qwen se plante
Voilà le moment que vous attendiez tous. Ma première version envoyait les lignes brutes au modèle, avec cette consigne : « réponds uniquement en JSON ». Réponse de Qwen : une liste à puces en Markdown, avec des recommandations de pare-feu, et une phrase dont je me souviendrai longtemps : « l’utilisateur root a connecté des IPs ». Gné … mon cœur a fait un BLAM dans ma poitrine … En fait, Faux Positif : ce sont des lignes [preauth], et preauth veut dire « avant authentification », c’est-à-dire que la connexion s’est arrêtée avant d’aboutir. Le vrai chiffre sur l’heure en question : 201 lignes SSH, 184 en [preauth], et zéro connexion réussie. Il m’a aussi sorti « probablement un botnet » … hé ho, te prends pas pour un jeune de la Cyber qui vient d’arriver … sans aucune preuve en plus, et comble du rigolo, il me recommandait très sérieusement de bloquer… ma propre adresse IP 🙂 :). Si j’avais branché ça sur un pare-feu, je m’enfermais dehors tout seul.
La leçon est simple : un modèle de 8 milliards de paramètres ne compte pas et n’a pas de contexte (ou si peu). Il ne sait pas que telle IP est la mienne, il lit « root » et « disconnect » dans la même phrase et il s’affole. Il ne suit pas non plus fidèlement un format imposé. Donc on lui retire tout ce qui peut se calculer :
– le nombre de connexions réussies (le code compte les Accepted)
– le nombre d’IP différentes
– les IP de confiance (écartées avant tout)
– la gravité (décidée par la règle plus haut)
– et jamais d’action : ni blocage, ni modification, seulement de l’information
Il ne reste à Qwen qu’un rôle, celui qu’il tient bien : rédiger deux phrases lisibles par un humain à partir de chiffres fiables.
Le prompt
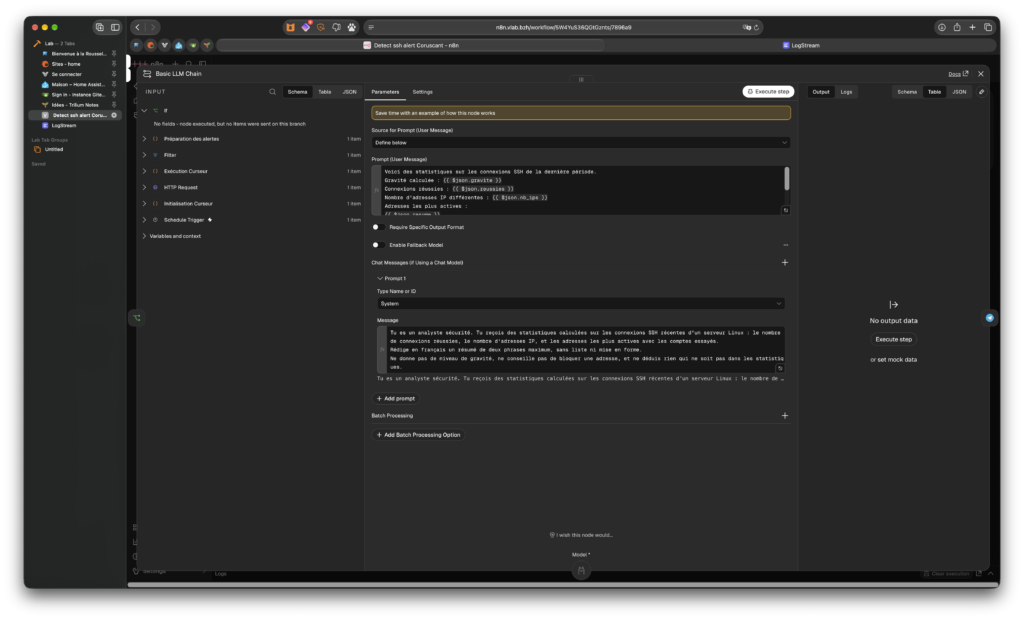
Dans le Basic LLM Chain, deux détails à connaître. D’abord, le champ « Source for Prompt » doit être sur Define below, sinon n8n cherche un champ chatInput qui n’existe pas et vous répond « No prompt specified ». Ensuite, on sépare deux messages : le message système donne le rôle permanent, et le message utilisateur apporte les données du moment.
Au final, le message système :
|
1 2 3 4 5 |
Tu es un analyste sécurité. Tu reçois des statistiques calculées sur les connexions SSH récentes d'un serveur Linux : le nombre de connexions réussies, le nombre d'adresses IP, et les adresses les plus actives avec les comptes essayés. Rédige en français un résumé de deux phrases maximum, sans liste ni mise en forme. Ne donne pas de niveau de gravité, ne conseille pas de bloquer une adresse, et ne déduis rien qui ne soit pas dans les statistiques. |
Le message utilisateur (en mode « Expression », pour que les {{ ... }} soient remplacés par les vraies valeurs) :
|
1 2 3 4 5 6 7 8 |
Voici des statistiques sur les connexions SSH de la dernière période. Gravité calculée : {{ $json.gravite }} Connexions réussies : {{ $json.reussies }} Nombre d'adresses IP différentes : {{ $json.nb_ips }} Adresses les plus actives : {{ $json.resume }} Commence ta réponse par : "Sur la période,". Cite l'adresse la plus active avec son nombre d'événements. N'interprète pas les noms de comptes essayés. |
Quelques astuces qui ont fait la différence. La consigne finale avec le début de phrase imposé (Sur la période,) : un petit modèle suit surtout le dernier texte qu’il lit, et sans ça, ayant lu une liste de chiffres, il continuait en produisant… une liste de chiffres. Et la ligne « cite l’adresse la plus active » : sans elle, certains résumés ne mentionnaient aucune IP, donc ne servaient à rien, et il se permettait de qualifier des noms de comptes de « connus » alors que rien ne le disait.
Et le résultat, par exemple : « Sur la période, les connexions SSH sont principalement issues de 9 adresses IP différentes, dont une a généré 14 événements avec plusieurs tentatives de connexion. La gravité globale reste faible, sans connexion réussie enregistrée. » Exact, sobre, et sans aucune invention. C’est tout ce que je lui demande.
Au passage, je suis honnête avec vous (comme toujours) : avec des données aussi propres, un simple modèle de phrase écrit à la main ferait presque le même travail. L’intérêt réel d’un LLM, c’est sur des logs variés et imprévisibles (erreurs d’applications, messages du noyau, WordPress qui râle) où aucune règle écrite d’avance ne suffit. Ce sera pour la suite.
La notification Telegram
Dernière étape, Telegram. Dans l’application, on parle à @BotFather, bon je ne vous fais pas toute la prose pour connecter un bot Telegram, sachez que c’est simple et rapide à faire. Dans n8n, le nœud Telegram (action « Send a text message ») prend le token dans un identifiant, le Chat ID, et un texte. J’y mets la gravité (que je vais chercher dans le nœud d’avant, car Qwen ne renvoie que son texte) suivie du résumé :
|
1 2 |
SSH, gravité {{ $('Préparation des alertes').item.json.gravite }} {{ $json.text }} |
Le $('Préparation des alertes') est la manière de dire à n8n « va lire le champ dans ce nœud-là, plus haut dans le workflow ». Petit détail : par défaut, n8n signe chaque message d’un « This message was sent automatically with n8n ». Pour s’en débarrasser, on ajoute le champ Append n8n Attribution dans le nœud et on le met sur off.
Publier, et vérifier que ça tourne vraiment
Jusque-là, on a tout fait en test manuel, et n8n ne conserve la mémoire du curseur que pour un workflow publié. Un clic sur Publish, et le workflow tourne tout seul. L’onglet Executions permet ensuite de voir chaque passage. Le signe que le curseur fonctionne : dès le deuxième passage, le nombre d’items qui sort du nœud « Exécution Curseur » est très petit, parce qu’on ne relit plus que les nouveaux logs.
Vers l’infini et au-delà !
Pour le chapitre 3, du RAG sur ma propre documentation, des outils MCP, voire des agents plus autonomes qui enchaînent plusieurs étapes. Ça va roxxer du poney, je vous le dis …
Mais avant ça, j’ai déjà des idées pour prolonger ce workflow : un second chemin pour les erreurs applicatives (là, Qwen devient vraiment utile, car aucune règle ne couvre tout), et pourquoi pas un mode où LogStream pousserait lui-même les alertes à n8n au lieu d’être interrogé. Et surtout, une règle que je me suis fixée : le modèle explique, tant bien que mal ^^, mais ne décide pas, et ne déclenche jamais d’action a fortiori.
Références :
– n8n : https://n8n.io
– n8n, documentation des task runners : https://docs.n8n.io/hosting/configuration/task-runners/
– Ollama et Qwen 3 : https://ollama.com/library/qwen3
– LogStream, sur mon Gitea : https://gitea.vlab.bzh/vLab-BZH/logstream
– LogStream, sur GitHub si vous préférez : https://github.com/vblogio/logstream