Salut les gens ! J’espère que vous allez bien 🙂 . Aujourd’hui une traduction libre d’une vidéo de 51 minutes (en anglais) que je trouve hyper intéressante : « AI Infrastructure Explained (GPUs, vLLM, and LLM-D) », signée KodeKloud. Vous trouverez le lien en fin de billet.
Ce billet est une libre traduction et un résumé de cette vidéo. Ce n’est pas du mot à mot. J’ai condensé, reformulé et réorganisé. J’ai aussi ajouté des NDLR (en italique) pour expliquer les termes techniques, parce que le jargon de l’IA peut vite vous noyer. Pour le côté transparence : la transcription a été faite en local avec Whisper, et j’ai été aidé par mon majordome habituel pour le premier jet, que j’ai ensuite relu et retravaillé.
Cette vidéo m’a un peu tapé dans l’oel dans le sens ou elle explique parfaitement le challenge de la construction d’une infrastructure de production dédiée pour un LLM s’adressant potentiellement à des milliers (voire des myons !) d’utilisateurs. : typiquement, que se passe-t-il quand je tape une question dans un ChatGPT-like. Alors certes on parle d’un type de workload précis, mais au final, je divulgache un peu la conclusion de l’article mais, ce n’est « que de l’infra ». Ça parlera sans doute à beaucoup de monde ici, hormis les spécificités liées aux LLM et de l’inférence en général.
Un marché qui s’emballe
Quelques chiffres pour planter le décor. Amazon, Google, Microsoft et Meta dépensent à eux quatre plus de 700 milliards de dollars cette année en infrastructure IA (je peux me gourrer, ça évolue tous les jours, mais c »est un ordre d’idée). C’est quatre fois plus qu’il y a quatre ans, juste avant le lancement de ChatGPT. Et la hausse est d’environ 80 % sur la dernière année. Un cabinet d’analyse (McKinsey, si j’ai bien compris) table sur près de 7 000 milliards de dollars investis dans les datacenters d’ici 2030. Autant dire que « ya du boulot » …
Rappel du principe d’un LLM : Une formule et des poids
Commençons par le début. ChatGPT, c’est en fait deux choses collées ensemble : le chat, c’est le site web, l’application et le Generative Pre-trained Transformer (GPT), le modèle, celui qui lit votre question et fabrique (prédit) la réponse. Claude, Gemini, DeekSeek, Mistral ou Llama sont d’autres modèles. Même principe partout.
Pour comprendre, la vidéo prend l’exemple le plus bête possible. Une petite machine type « boite noire » à qui vous donnez un nombre. Vous lui donnez 3, elle rend 6. Vous lui donnez 10, elle rend 20. Elle double tout. Cette machine est un modèle : une entrée, un calcul, une sortie. Dans cette machine, il y a deux choses. D’abord la formule (entrée, multiplication, sortie), qui ne bouge pas. Ensuite le nombre caché dedans, ici le « 2 ». C’est ce que la machine a « appris ». On l’appelle un poids (weight en anglais). Si vous changez 2 en 3, la même formule triple au lieu de doubler.
NDLR : un poids (ou paramètre) est un nombre appris pendant l’entraînement. Il dit à la formule à quel point telle ou telle chose compte dans le résultat.
Pour aller plus loin, imaginez que vous voulez deviner le prix d’une maison. Vous avez la surface, le nombre de chambres, l’âge de la construction. Chacun pèse un peu sur le prix, avec son propre poids. D’où viennent ces poids ? Vous ne les inventez pas. Vous montrez à la formule des milliers de maisons réelles avec leur prix de vente, et elle calcule les poids qui collent le mieux. C’est ça, la phase d’entraînement du modèle. C’est cette phase qui prend énormément de temps initialement (plusieurs semaines, ou plusieurs mois, avec des fermes de GPU … comme des mineurs de crypto 🙂 ).
Maintenant, faites grossir tout ça. Plus d’entrées, plus de multiplications, plus de poids, empilés en couches. Avec un agencement bien précis, vous obtenez la forme de tous les modèles de langage modernes (les world models ce sera pour une autre fois …) : le transformer. Le transformer, c’est la formule. Elle tient en une page de code et elle est à peu près la même pour GPT, Claude ou Llama. Ce qui change d’un modèle à l’autre, ce sont les poids.
Et un vrai modèle, ce n’est pas 4 poids ou 400. Ce sont des milliards de nombres, stockés dans… un gros fichier. Un gros fichier. Rien d’autre. Un petit modèle pèse environ 2 Go. Un modèle moyen, monte à 16 Go (par exemple Qwen3 pèse environ 5 à 6 Go). Un gros, à 70 milliards de paramètres, 140 Go. Et les géants, (500 milliards et plus) se comptent en centaines de Go (imaginez les modèles frontières de OpenAI, Anthropic ou Mistral … ça laisse rêveur.
Utiliser un modèle, c’est donc : charger le fichier en mémoire, lui donner du texte, récupérer du texte. et paf, ça fait des choc … aheum, pardon :).
A l’échelle locale sur des machines « consumer », CPU, GPU et VRAM
Si un modèle n’est qu’un fichier et un peu de maths, pourquoi ne pas simplement le lancer sur votre portable ?
Le CPU est un excellent généraliste : quelques cœurs très costauds qui enchaînent les tâches l’une après l’autre. Parfait pour votre navigateur ou votre OS. Par contre, faire tourner un modèle, ce sont des milliards de petites multiplications indépendantes. Elles pourraient toutes se faire en même temps. Un CPU les traite globalement les unes après les autres (allez, disons une vingtaine ou une trentaine pour les gros CPU). Autant dire qu’on a pas des myons d’années devant nous ^^.
C’est là qu’arrive le GPU. Il est construit à l’opposé : au lieu de quelques gros cœurs, des milliers de petits cœurs qui calculent tous en même temps. Un GPU modeste comme le NVIDIA T4 en a environ 2 500. Côté chiffres, un CPU fait de l’ordre de 10 000 milliards d’opérations par seconde, un GPU s’approche de 1 000 000 de milliards. Environ 100 fois plus de maths par seconde.
NDLR : À l’origine pour les jeux vidéo, aujourd’hui le cœur de l’IA. TFLOPS = milliers de milliards d’opérations par seconde, la mesure de la puissance de calcul.
Mais le GPU crée un nouveau problème. Il faut le nourrir en données (les poids, donc). Si elles restent dans la RAM du PC, elles passent par un tuyau étroit d’environ 64 Go/s (en moyenne), soit 50 fois trop lent pour des milliers de cœurs affamés. Résultat : les cœurs attendent.
La solution, c’est de donner au GPU sa propre mémoire, soudée sur la cart, juste à côté de ses cœurs : la VRAM. Le tuyau est bien plus large (des To/s au lieu de Go/s). Mais la VRAM est rapide et petite : un T4 n’a que 16 Go, alors qu’un modèle de 70 milliards de paramètres demande 140 Go rien que pour ses poids. A garder dans un coin de cerveau, on y reviendra.
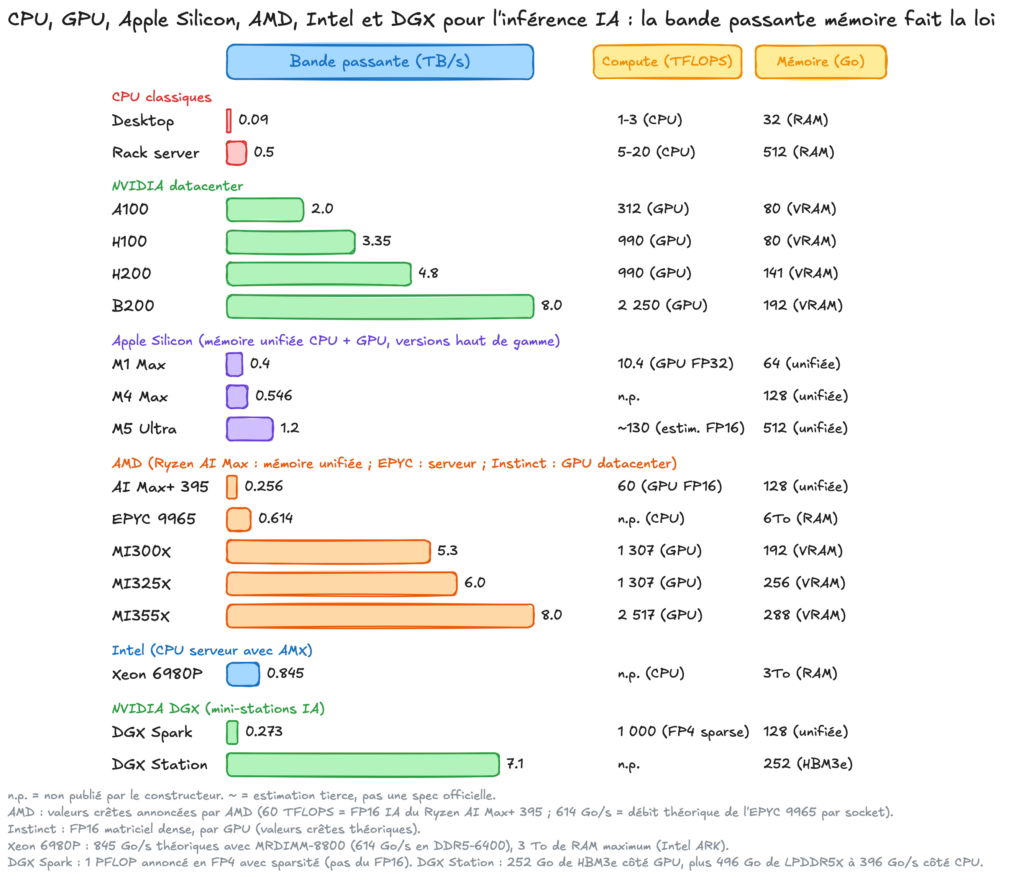
Toutes les cartes GPU/IA se décrivent avec trois nombres : le calcul (TFLOPS), la capacité (Go de mémoire) et la bande passante (To/s). Voici un schéma a peu près représentatif de ce qu’on peut trouver aujourd’hui (j’ai complété ce qu’annonçait la vidéo) :
Le serveur de modèle : vLLM
Une puce seule ne fait rien. Il faut un logiciel pour la piloter : PyTorch (à l’origine) charge le modèle sur le GPU en quelques lignes de code. Parfait pour essayer sur son portable. Mais c’est un script : il tourne une fois, pour une personne, puis il s’arrête.
Or les vrais utilisateurs sont des milliers en même temps. Il faut un service qui reste allumé et qui écoute 24h sur 24h. C’est un serveur de modèle, et celui dont parle la vidéo (et qui y revient tout le long) est vLLM.
NDLR : vLLM est un serveur open source qui enveloppe un modèle dans une API web classique. Il tourne par-dessus PyTorch.
Une seule commande suffit, vLLM lit les poids sur le disque et les charge dans la VRAM (16 Go à déplacer, comptez une à deux minutes). Ensuite, il attend les requêtes. Petit détail marrant, toutes la standardisation est en route au moment ou je vous parle : vLLM parle le même format que l’API d’OpenAI. Tout outil ou script qui parle déjà à OpenAI peut parler à votre serveur sans changer une ligne (le projet Github est en lien en fin d’article).
Mais retenez ceci : ce serveur garde le modèle entier en mémoire GPU en permanence. En avoir un deuxième, c’est une deuxième copie du modèle sur un deuxième GPU (hors de prix). Un serveur de modèle est une grosse bébète : cher à faire tourner, lent à démarrer, coûteux à copier.
Le nerf de la guerre aujourd’hui : le token
Avant d’aller plus loin, un petit mot le token.
NDLR : un modèle ne lit pas des mots entiers mais des morceaux de mots, les tokens. Un token vaut en gros trois quarts de mot. « Serving LLMs is not like serving web apps » fait 8 mots, mais environ 9 tokens. Ce que vous pouvez lire, ce que vous payez, la vitesse de réponse : tout se compte en tokens.
Le modèle ne sait faire qu’une seule chose au final : prédire le token suivant à partir de tout le texte précédent. et il l’ajoute au texte, et ensuite il recommence, encore et encore, jusqu’à la fin de la réponse. Une réponse de 100 tokens, c’est donc 100 tours de cette boucle. C’est pour ça que ChatGPT « tape » sa réponse mot après mot : vous regardez les tours se terminer en direct. Deux conséquences, qu’on retrouvera plus loin. Un : ces requêtes sont longues (une requête web classique, c’est quelques millisecondes ; ici, des centaines de tours). Deux : il n’y a pas deux requêtes identiques. « Quelle est la capitale de la France ? » représente quelques tokens en entrée et un ou deux en sortie. « Résume-moi ce contrat de 100 pages » représente des dizaines de milliers de tokens. Même serveur, même API, mais l’un coûte mille fois plus que l’autre.
La pause et le flux : prefill et decode
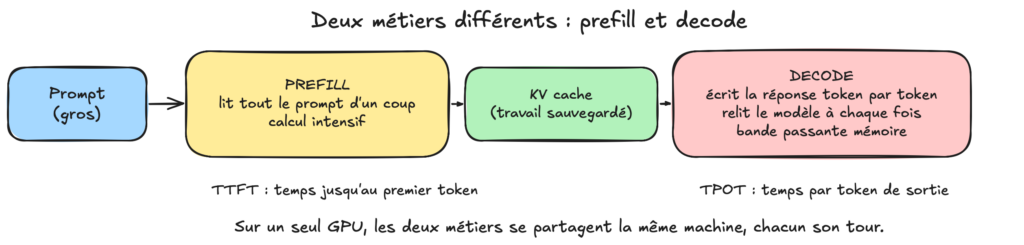
Vous collez un gros texte dans ChatGPT, vous appuyez sur Entrée. Il se passe une ou deux secondes de pause, puis la réponse arrive en flux régulier. en fait, ce sont les deux moitiés de la boucle.
La pause. Avant d’écrire un mot, le modèle doit lire tout votre prompt. Il le lit d’un seul coup : tout le prompt est déjà là, donc tous les tokens passent ensemble dans le modèle, en une grosse rafale. Des milliers de cœurs travaillent en même temps. À la fin, le premier token de la réponse sort. Si vous demandez la capitale de la France, la rafale est minuscule. Si vous collez un contrat de 100 pages, elle devient une vraie attente qui peut rapidement se compter en dizaines de secondes.
NDLR : cette première phase s’appelle le prefill, et l’attente qu’elle provoque le TTFT (Time To First Token, le temps avant le premier token).
Le flux. Ensuite, c’est la boucle token par token. Chaque token demande un passage complet dans le modèle. Et pour ça, le GPU doit relire tout le modèle depuis sa mémoire. Une réponse de 200 tokens, c’est 200 relectures complètes du modèle, chacune ne donnant qu’un seul token. Les cœurs font très peu de travail. Ils attendent la mémoir.
NDLR : cette seconde phase s’appelle le decode, et le temps entre deux tokens le TPOT (Time Per Output Token).
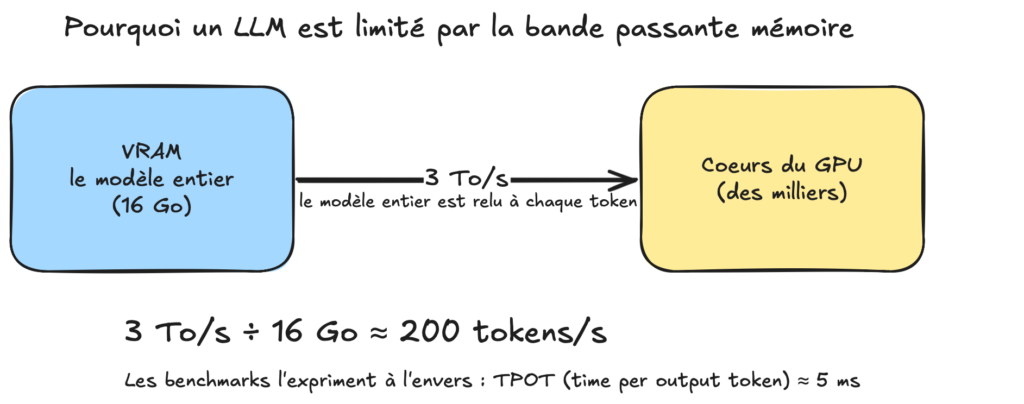
La limite de vitesse, la voici : un GPU haut de gamme lit sa mémoire à environ 3 To/s. Avec un modèle de 16 Go, il ne peut le relire qu’environ 200 fois par seconde. Soit 200 tokens/s maximum, ou un token toutes les 5 millisecondes. Les benchmarks parlent généralement de cet écart de 5 ms (le TPOT).
Résumons : le prefill est un gros bloc de calcul, une fois. Le decode est une longue corvée de bande passante mémoire. Deux métiers très différents, et pour l’instant, ils se partagent le même GPU, chacun son tour. Gardez cette idée.
Le cache caché : KV cache et prefix caching
Si on refaisait le prefill avant chaque nouveau token, il y aurait une pause avant chaque mot et le chat serait inutilisable. Ce n’est pas ce qui se passe. Le prefill est un travail coûteux, alors au lieu de le jeter, le modèle le sauvegarde dans la mémoire du GPU.
NDLR : ce travail sauvegardé s’appelle le KV cache. Le prefill tourne une fois, remplit le cache, puis chaque nouveau token réutilise ce qui est déjà calculé et n’ajoute que sa propre part.
Mais tout ça ne vaut que pour un seul message. Quand la réponse est finie, le cache est vidé. Et le modèle n’a aucune mémoire entre deux messages : votre application renvoie toute la conversation à chaque fois (première question, première réponse, nouveau message). Le serveur relit tout depuis le début. Plus vous discutez, plus vous attendez car plus la relecture du contexte prend du temps !
Alors, et si on gardait le cache ? On le range, étiqueté par le texte exact qui l’a produit. Au tour 2, le modèle voit qu’il a déjà fait le travail sur toute la conversation, sauf le dernier message. Il ne fait le prefill que de celui-ci. Le tour 10 coûte à peu près ce que coûte le tour 2.
NDLR : cette astuce s’appelle le prefix caching. Si vous utilisez l’API d’Anthropic, vous connaissez le « prompt caching » : un token d’entrée en cache coûte environ dix fois moins qu’un token neuf. C’est la même idée.
Et en bonus, cela marche pour tout le monde. Le travail sauvegardé pour un bout de texte ne dépend que du texte qui précède, pas de la personne. Si vous avez un assistant d’entreprise dont chaque conversation commence par le même long bloc d’instructions, le modèle ne fait ce travail qu’une fois et le réutilise pour tous les utilisateurs.
Plusieurs utilisateurs sur un seul GPU : le batching
On a vu que pour produire un token pour une personne, le GPU doit relire tout le modèle. Cette lecture, c’est le vrai coût. Alors pourquoi ne pas profiter de la même lecture pour produire le token suivant de plusieurs personnes à la fois ? Une lecture du modèle donne 1 token pour 1 utilisateur, ou 50 tokens pour 50 utilisateurs. C’est la même lecture.
NDLR : c’est le batching. On regroupe les requêtes de plein de gens et on les fait passer ensemble dans le GPU. Chacun reçoit sa réponse à peu près à la même vitesse qu’en solo, mais le débit total du serveur (le nombre de tokens produits par seconde) explose.
On sert donc 50 personnes pour le prix de… à peu près une. Sans batching, ce serait un enfer de prix et d’attente.
Alors pourquoi pas un million d’utilisateurs d’un coup ? Rappelez-vous, à cause de la mémoire. Chaque personne dans le lot a besoin de son KV cache, en mémoire GPU, tant qu’elle est servie. Or cette mémoire est déjà bien entamée par le modèle lui-même. Ce qui reste, c’est la place disponible pour les caches de tous. Quand c’est plein, c’est plein : les nouveaux attendent, ou le cache de quelqu’un d’autre saute pour leur faire de la place. C’est exactement pour ça que ChatGPT vous dit parfois qu’il est « à capacité ».
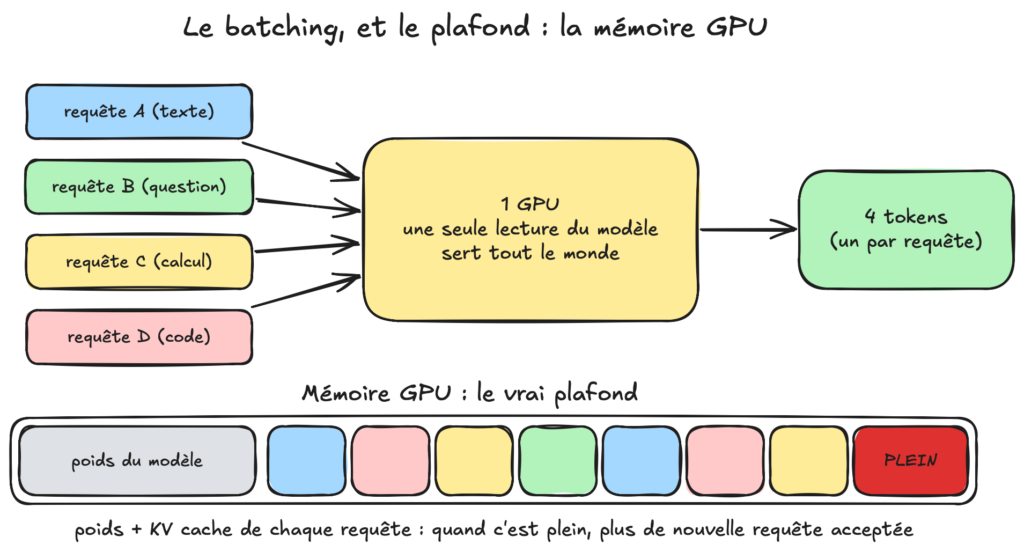
Notez bien ce qui n’est pas le problème : ce n’est pas le calcul (les cœurs ont plein de maths disponibles). C’est la mémoire qui décide combien de personnes un GPU peut servir. Et c’est là que beaucoup d’argent est gaspillé : des équipes achètent bien plus de GPU que nécessaire, qui tournent à moitié vides. quelle tristesse : … alors que GTA 6 s’apprête à sortir :).
Quand le modèle est trop gros : le sharding
Jusqu’ici, chaque serveur tient le modèle entier. Pour les très gros modèles, ça ne marche plus. Un modèle de 140 Go ne rentre pas dans un GPU de 80 Go. Et les géants à plusieurs centaines de Go, encore moins (imaginez les modèles frontière …).
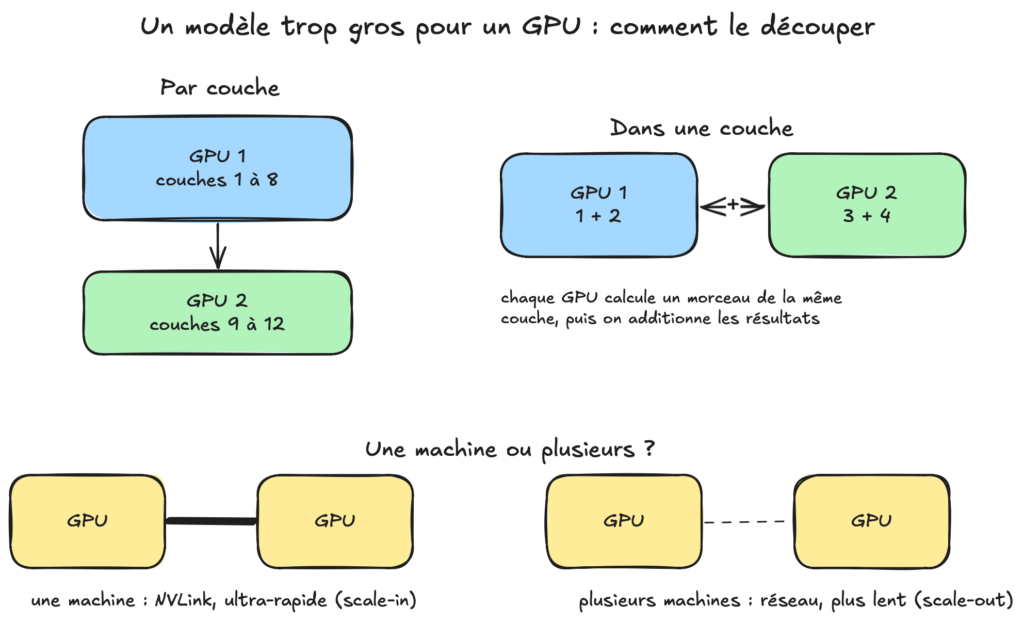
La solution, c’est de le découper en morceaux et de mettre un morceau sur chaque GPU. Aucun GPU ne porte le tout, mais ensemble, ils le portent. Bonne nouvelle : vLLM sait le faire tout seul. Vous lui donnez le modèle, le nombre de GPU, il se débrouille.
Pour comprendre la découpe, rappelez-vous qu’un modèle est un empilement de couches. Votre prompt entre en haut, descend couche après couche, chacune additionne ses nombres et passe le résultat à la suivante, jusqu’au token final. Deux façons de couper : par couche (les premières couches sur le GPU 1, les suivantes sur le GPU 2), ou dans une couche (le GPU 1 additionne la première moitié des termes, le GPU 2 la seconde, puis on combine).
Laquelle choisir ? En fait, tout dépend de la vitesse de la bande passante entre les GPU. Dans une même machine, ils sont reliés par un lien ultra rapide, le NVLink. La méthode bavarde (couper dans une couche) y fonctionne très bien : les GPU peuvent se parler en permanence. C’est ainsi que tournent la plupart des gros modèles aujourd’hui (jusqu’à 8 GPU dans une boîte), c’est pour cela que vous voyez quelques fois des serveurs monstres qui intègrent 8 voir plus de GPU 🙂 . Entre plusieurs machines, le réseau est bien plus lent : on passe à la méthode légère (par couche), où chaque machine ne passe qu’un petit résultat à la suivante. La règle simple à comprendre : on bavarde au sein du serveurs en scale-in, on murmure entre les serveurs en scale-out
NDLR : découper un modèle sur plusieurs GPU s’appelle le sharding. Le géant tourne alors sur plusieurs machines qui agissent comme un seul serveur.
Une flotte de serveurs : pourquoi le load balancer classique ne marche plus
Un vrai service ne tourne jamais sur un seul serveur. Il en faut toute une flotte, chacun avec son GPU coûteux et sa copie du modèle. Comment load balancer tout cela ?
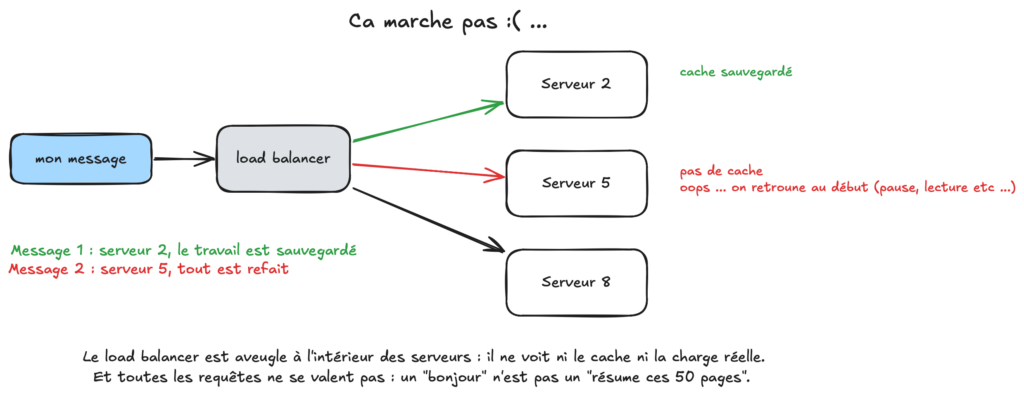
Notre réflexe d’infra : un load balancer devant la flotte, qui répartit tout à tour de rôle. On fait ça avec le web depuis des décennies. Sauf que pour les LLM, c’est le mauvais outil, pour deux raisons :
Première raison : le cache. J’envoie mon premier message, il tombe sur le serveur 2, qui lit ma conversation et sauvegarde son travail (le KV cache). Un peu plus tard, j’envoie mon second message. Le load balancer, dont le métier est de répartir, l’envoie au serveur 5. Qui ne me connaît pas, n’a rien en cache, et doit tout relire depuis zéro. Le prefill est refait. On a jeté du travail parfaitement bon, sur le matériel le plus cher qu’on possède.
Seconde raison : la taille des requêtes. Un load balancer suppose que toutes les requêtes se valent. Or un « bonjour » n’a rien à voir avec un « résume ces 50 pages ». Pour lui, elles se ressemblent : même adresse, même trafic. Il peut donc envoyer les 50 pages sur un serveur déjà en train de servir 30 personnes. Les 30 ralentissent, et la grosse requête prend un temps fou. Il ne peut pas le savoir : tout ce qu’il faudrait connaître est à l’intérieur des serveurs (remplissage mémoire, travail sauvegardé, longueur de la file).
Bref, servir des LLM est difficile : Le modèle tient à peine en mémoire. Chaque token force à relire tout le modèle. Le travail sauvegardé reste collé à un seul serveur. La mémoire limite le nombre de personnes servies. Et un mauvais routage gaspille du GPU, c’est-à-dire de l’argent, du brouzouf, du pognon, d’la’thunasse :).
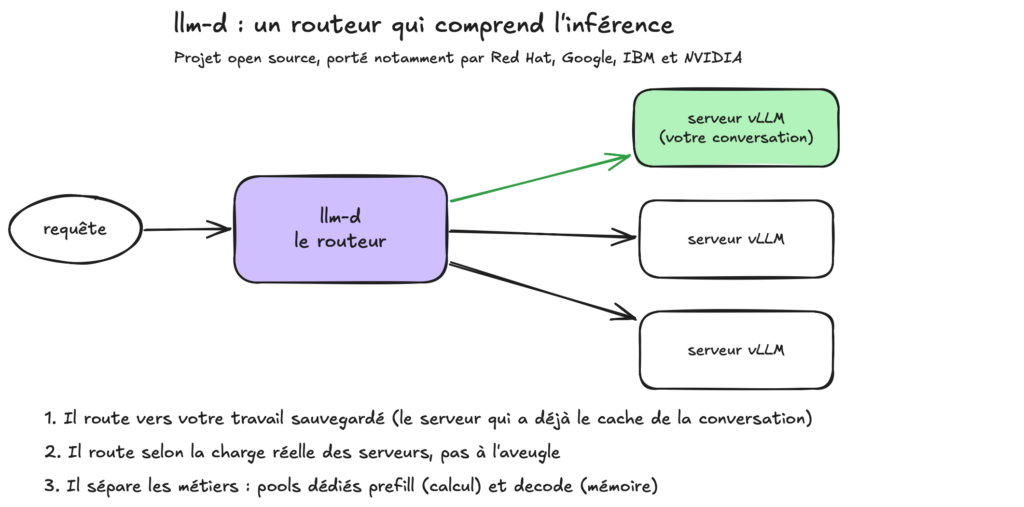
llm-d : un routeur qui comprend l’inférence à l’entrée
Ce mur a bloqué toute l’industrie pendant quelques années, et c’est pour ça que Red Hat, Google, IBM et NVIDIA ont décidé de s’attaquer au problème ensemble, en open source. Le résultat s’appelle llm-d.
Finalement, c’est un load-balancer intelligent que vous positionnez devant une flotte de machines. Il ne balance pas la requête sur le premier serveur libre. Il réfléchit, puis l’envoie au serveur le mieux placé, en regardant trois choses : le travail sauvegardé par chaque serveur, la mémoire libre, et la longueur de la queue.
Première fonctionnalité : il sait quel serveur détient quel cache. Votre message suivant repart tout droit vers le serveur qui a déjà votre conversation. Pas de relecture, la réponse arrive vite. Rien qu’avec ça, la vidéo annonce environ 3 fois plus de débit et un premier token 2 fois plus rapide, sur le même matériel (je fait confiance à KobeCloud).
Deuxième fonctionnalité : il regarde à l’intérieur de chaque serveur, là où un load balancer ne va pas. Mémoire pleine ? File longue ? Il envoie votre requête là où il y a vraiment de la place.
Troisième fonctionnalité : il sépare prefill et decode. Vous vous souvenez : deux métiers différents qui se partagent un GPU. Quand quelqu’un colle 50 pages, son énorme prefill fait attendre tout le monde en plein milieu de leur réponse. llm-d peut donc créer deux pools : un qui ne fait que du prefill (du calcul pur), l’autre que du decode (de la mémoire pure). Chacun avec le matériel adapté. Par exemple, des H100 pour le prefill et des H200, plus riches en mémoire, pour le decode. Quand un serveur de prefill a fini de lire un prompt, il passe le travail sauvegardé à un serveur de decode via un lien rapide. Selon la vidéo, jusqu’à 70 % de tokens par seconde en plus sur le même matériel.
Et le clou du pestacle : ça tourne sur Kubernetes !
La belle nouvelle pour nous, c’est que llm-d est posé sur une plateforme bien connue : Kubernetes. D’après un billet de la CNCF cité dans la vidéo, environ deux tiers des organisations qui hébergent de l’IA générative (60 %) l’utilisent pour tout ou partie de leur inférence. Votre équipe ops donc finalement fait de l’IA sans le savoir si elle opère déjà du Kube !
Malgré tout, chaque notion vue plus haut cache un choix d’archi et un dimensionnement adapté. Combien le routeur favorise un serveur qui a votre cache plutôt qu’un serveur moins chargé ? Sépare-t-on prefill et decode, et combien de serveurs pour chaque ? Sur combien de GPU s’étale un modèle trop gros ? Combien de requêtes par lot ? Chaque réglage influence la vitesse ainsi que le coût, et la bonne valeur dépend de votre modèle, de votre matériel et de votre trafic au final. C’est tout l’enjeu des infra IA massives aujourd’hui.
llm-d vous livre donc des recettes prêtes à l’emploi qu’il s’agit de vérifier avec des spécialistes, comme toujours.
Je vous laisse découvrir cette partie plus technique car elle sort un peu du sujet plus général de cet article. Mais elle est tout aussi intéressante 🙂
Conclusion (la vidéo a la même)
Du routage et du load balancing, du cache, de l’autoscaling, de la mémoire et du réseau. Presque rien de tout ça n’est du machine learning. C’est de l’infrastructure, de la première leçon à la dernière. Les modèles sont nouveaux, mais la discipline, nous l’avons déjà et moyennant un peu d’adaptation les concepts sont déjà là 🙂
Si vous êtes admin sys, ou expert en conteneurs (kube ou non), vous êtes bien plus proche de ce monde que vous ne le pensez. Linux, conteneurs, Kubernetes et supervision sont la fondation de toute plateforme IA. Il faut ensuite ajouter la couche IA par-dessus : comprendre comment fonctionnent les GPU, les serveurs de modèles comme vLLM, et l’orchestration avec llm-d. C’est exactement la pile décortiquée dans la vidéo. Et d’après elle, les équipes ont du mal à recruter justement ces profils. Alors jetez vous ! Pas besoin de devenir data scientist ni d’entraîner des modèles : il suffit de pointer les compétences qu’on a déjà vers un nouveau workload.
Suite à cette vidéo je comprends mieux des gens comme David Legeay sur linkedIn que je suis depuis plusieurs mois et qui travaillent énormément sur ces sujets et pourquoi ça a l’air passionnant ! ouin ! je veux des sous pour avoir quelques Mac Studio M5 Max … 🙂
Bref, les problèmes difficiles de l’IA sont devenus des problèmes d’infrastructure, et on est bien placés pour les résoudre. Vivement qu’on en discute ! Dites-moi en commentaire si vous avez déjà fait tourner vLLM ou llm-d chez vous, je suis TRES intéressé ^^
A bientôt pour le chapitre 4 de ma série sur l’IA Locales !
Références :
AI Infrastructure Explained (GPUs, vLLM, and LLM-D) : https://www.youtube.com/watch?v=hBzUokVYQkI
– David Legeay sur LinkedIn: https://www.linkedin.com/in/davidlegeay/
– llm-d : https://llm-d.ai
– KodeKloud, parcours IA : https://kodekloud.com/learning-path/ai
– Le projet vLLM sur Github : https://github.com/vllm-project/vllm